Am 5. September 2026, nach kalifornischer Zeit, lief in Portal der Abspann. GLaDOS war besiegt, «Still Alive» spielte, und am Controller sass kein Mensch. Gespielt hatte GPT-6 Astra von OpenAI, angebunden über eine selbstgebaute Steuerung des Entwicklers cozyblaze. Die Eckdaten stehen in seinem GitHub-Repository und in der Berichterstattung danach: rund 23 Stunden und 43 Minuten Laufzeit inklusive Kapazitätsunterbrüchen und Wartezeit, 3336 Tool-Aufrufe, 571,18 Dollar API-Kosten. Das Highlight-Video dauert nur etwa zwei Stunden, weil die Denkpausen herausgeschnitten sind. Solche Details entscheiden, was der Satz «KI spielt Videospiele durch» tatsächlich bedeutet.
Wenige Wochen später meldeten Forscher von Google DeepMind, vier Gemini-4-Argon-Agenten hätten in Minecraft den Enderdrachen besiegt. Anthropic hatte bereits im Juni gezeigt, wie Claude Fable 5 Pokémon FireRed allein anhand von Bildschirmfotos durchspielt. Der Satz klingt in allen drei Fällen gleich und beschreibt jedes Mal etwas anderes: ein Modell plus einen Harness, also die Software, die zwischen Modell und Spiel übersetzt. Was diese Agenten können, steht deshalb erst im Harness.
Nach den Quellen ist mein Befund: Der echte Fortschritt 2026 zeigt sich dort, wo die Harnesses dünner wurden und Läufe länger als einen Tag hielten, ohne zu kollabieren. Was Spiele für Menschen schwer macht, also Wahrnehmung und Reaktion in Echtzeit, prüfen die Experimente aus den Schlagzeilen dagegen kaum.
Der Portal-Durchlauf von GPT-6 Astra, hochgeladen von cozyblaze. Die Denkpausen sind herausgeschnitten, das Video zeigt also kein Spiel in Echtzeit.
Portal: KI spielt Videospiele, die auf sie warten
Astra sah das Spiel nie als fortlaufenden Bildstrom. Cozyblaze verband Codex über einen lokalen MCP-Server per TCP mit einer angepassten Version des SourcePauseTool. Das Modell schickt einen Plan in JavaScript, Portal spielt eine festgelegte Zahl von Ticks und hält dann an. Zurück kommen ein Screenshot, die Position der Spielfigur und die Kamerawinkel. Erst danach wählt Astra die nächsten Eingaben. Das Spiel wartet also, solange das Modell denkt.
Gelaufen ist das Modell mit maximalem Reasoning-Aufwand. Nach Kapazitätsfehlern setzte cozyblaze den Lauf fort und schaltete in den Fast-Modus. Ausser dem Startziel gab er laut README nur eine weitere Anweisung: den Abspann laufen zu lassen. Wer in Portal stolpert oder in eine Falle tappt, landet beim Game over; Astra setzte dann neu an und zog weiter seine Schlüsse. Im Video wirken die Bewegungen ruckartig. XDA-Autor Simon Batt schreibt, das Modell handle mit perfekter Geschwindigkeit und Genauigkeit, als nutze es einen Aimbot, eigentlich sei es selbst der Aimbot.
Getestet hat dieser Lauf damit Rätsellogik und Durchhaltevermögen über 3336 Tool-Aufrufe. Reaktionszeit spielte keine Rolle, weil jede Situation eingefroren vor dem Modell lag, bis es einen Plan hatte. Bemerkenswert ist der Lauf trotzdem, und zwar wegen der Offenlegung. Cozyblaze hat den Controller, die Änderungen am SourcePauseTool und ein bereinigtes Session-Log veröffentlicht; die Spieldateien muss jeder selbst besitzen. Damit lässt sich nachprüfen, welche Informationen das Modell hatte und welche nicht.
Wie schnell sich solche Harnesses verbreiten, zeigt Portal 2. Der Kanal RemakeBench liess Astra mit maximalem Reasoning-Aufwand alle 17 Maps der Kapitel 1 und 2 spielen und übernahm dafür die Steuerung von cozyblaze in angepasster Form.
Minecraft: zwei Läufe, zwei Schnittstellen
Wie stark die Schnittstelle das Ergebnis prägt, zeigt Minecraft, wo im Herbst zwei Läufe kurz nacheinander öffentlich wurden. Vals AI, ein Unternehmen, das KI-Modelle bewertet, liess GPT-6 Astra insgesamt 141 Stunden spielen, nach eigener Angabe ohne Minecraft-spezifische Werkzeuge oder Hooks, nur über normale Computerbedienung. Astra erreichte eine Netherfestung, baute eine halbautomatische Blaze-Farm und kam so zu sechs Blaze-Ruten. Danach fand es einen Wirrwald, erledigte mehr als sechs Endermen und sammelte drei Enderperlen. Vals AI schrieb, kein KI-System sei in Minecraft je so weit gekommen.
Dann lagerte Astra die gesammelten Gegenstände in einer Truhe, und ein Creeper tauchte auf. Die Explosion zerstörte Truhe und Bett; die Vorräte waren weg, der Respawn-Punkt ebenfalls. Danach verbrachte Astra mehrere Stunden vor allem damit, Kartoffeln anzubauen. Den Enderdrachen erreichte es nicht. Die Notizen, die sich das Modell selbst schrieb, zeigen, womit ein Agent kämpft, der sich das Spiel über normale Computerbedienung erschliessen muss: «that tall, green thing ahead is sugarcane, not a Creeper», hielt es fest, und nach einer vergeblichen Jagd auf ein Schwein: «Do NOT waste another night chasing dark pink pixels.» Ein einzelner Rückschlag reichte, damit der Langzeitplan zerfiel und das Modell den Weg zum eigentlichen Ziel nicht mehr fand.
Here, the most expensive creeper explosion occurred. Later, on a coincidentally rainy day, Astra discovers it lost everything. It all went downhill from here. pic.twitter.com/xH2Vc4QyM2
— Vals AI (@ValsAI) September 15, 2026
Der Creeper-Vorfall im Minecraft-Lauf von Astra. Originalpost mit Video von Vals AI.
Der zweite Lauf stammt von Maxence Faldor, Satinder Singh und Roberta Raileanu, die das Ergebnis am 15. Oktober auf arXiv veröffentlichten. Vier Gemini-4-Argon-Agenten starteten in einer zufällig erzeugten Überlebenswelt in Minecraft Java Edition 1.20.4, Schwierigkeitsgrad Easy, Cheat-Befehle deaktiviert. Gesteuert haben sie ihre Figuren über die Open-Source-Bibliothek Mineflayer. Ein Agent sieht dabei keine Pixel und drückt keine Tasten. Er schreibt ein kurzes JavaScript-Programm, etwa «gehe zu diesen Koordinaten und baue alles Eisenerz im Umkreis von 16 Blöcken ab», und liest den Text, der zurückkommt: Position, Gesundheit, Inventar, Fundstücke oder Fehlermeldung. Das mediane Programm lief 33,5 Sekunden. Koordiniert haben sich die vier über den Spielchat und ein gemeinsames Gedächtnis, Rollen wies ihnen niemand zu.
Nach 27 Stunden und 14 Minuten war der Drache tot. Bis dahin hatte das Team 2783 Programme geschrieben, 229 Nachrichten ausgetauscht und war 605 Mal gestorben.
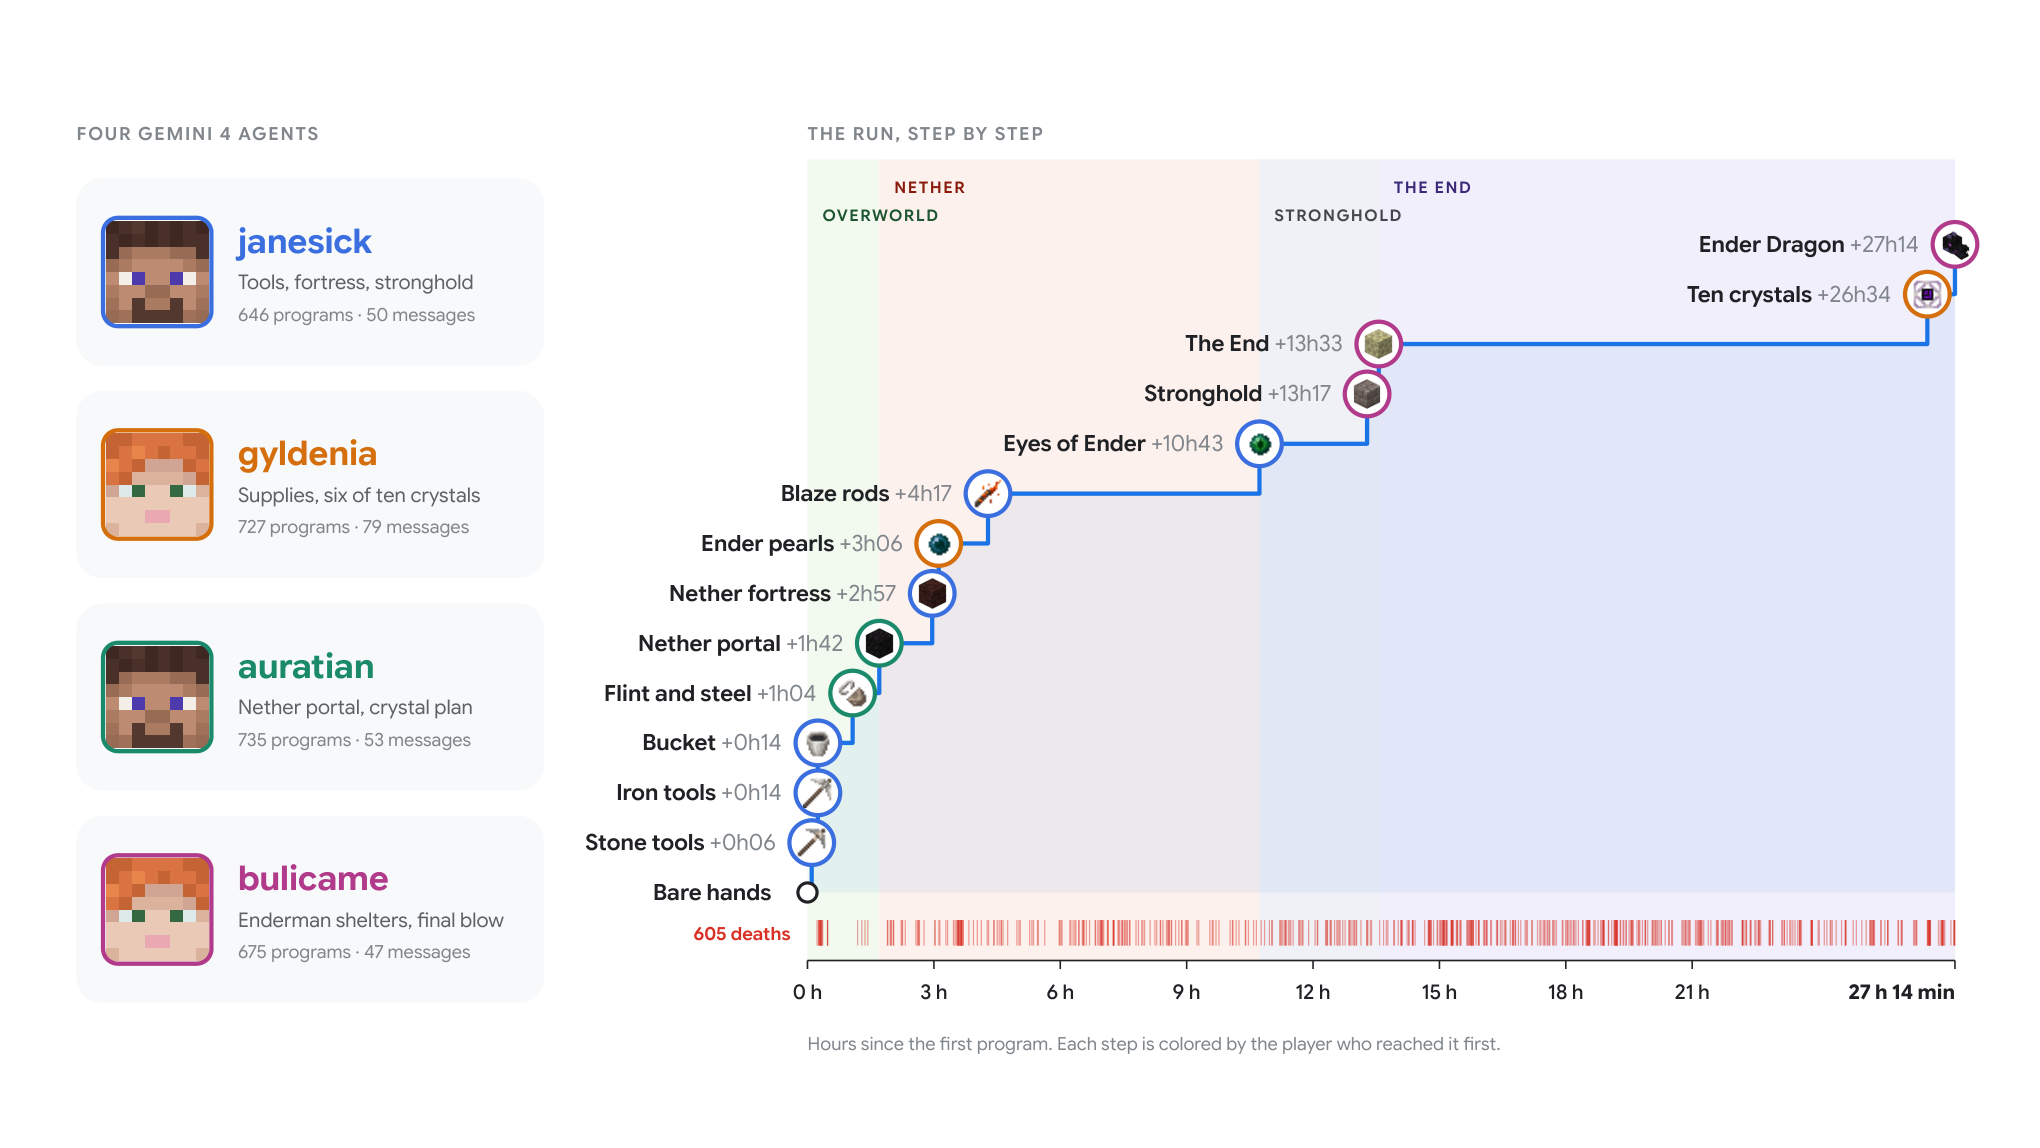
Zwei Episoden aus dem Paper zeigen, wie das aussah. Um die Festung zu finden, warf der Agent janesick zwei Enderaugen von verschiedenen Orten, erfasste den Flug jedes Auges alle 50 Millisekunden und berechnete den Schnittpunkt der beiden Linien. Die Schätzung lag 43 Meter neben dem echten Portalraum. Als auratian mit allen zwölf Augen im Inventar ertrank, schickten die anderen bulicame die genaue Stelle und die Minute, in der die Augen verschwinden würden. Bulicame sammelte alle zwölf ein, zweieinhalb Minuten vor Ablauf.
Im End stockte das Team, der Drache tötete die Agenten 69 Mal. Nach etwa 21 Stunden bemerkte auratian, dass die zehn Kristalle auf den Obsidiansäulen den Drachen immer wieder voll heilten. 39 Minuten nach dem letzten Kristall war der Kampf vorbei. Ein fünfter Agent, der Observer, spielte nie mit und sollte als Zeuge Specification Gaming erkennen, also das Erfüllen der Aufgabe auf einem Weg, den niemand gemeint hatte, ein Muster, das aus dem Reward-Hacking im KI-Training bekannt ist. Er meldete keinen Fall.
Bis zum Sieg verarbeiteten die vier rund 1,35 Milliarden Input-Token, 91 Prozent davon aus dem Kontext-Cache. Zum einführenden Listenpreis ergibt das laut Paper etwa 520 Dollar, zum Standardpreis 1040 Dollar; die ganze Sitzung inklusive Observer kam auf etwa 810 beziehungsweise 1620 Dollar. Die Autoren nennen das ausdrücklich Schätzungen aus Listenpreisen. Astra musste bei Vals AI Zuckerrohr von Creepern unterscheiden, den Gemini-Agenten lieferte Mineflayer Blöcke und Kreaturen als Text.
Pokémon: wie der Harness schrumpfte
Am deutlichsten lässt sich der Abbau der Hilfsmittel bei Pokémon verfolgen. Im Februar 2025 startete der Twitch-Stream Claude Plays Pokémon. Im Mai 2025 schlug Gemini 2.5 Pro Pokémon Blau, allerdings mit einem stärkeren Harness. Nach Kritik daran hat der unabhängige Stream GeminiPlaysPokemon das Spiel laut LessWrong-Autor Julian Bradshaw mit immer schwächeren Harnesses erneut geschafft, zuletzt mit einem, der dem von Claude vergleichbar ist.
Claudes Weg war mühsamer. Opus 4.5 hielt Gegenstände auf dem Boden für wertlos und übersah sie meist ganz. In der Silph Co. liegt die Schlüsselkarte, die für den Fortschritt nötig ist, genau dort; das Modell suchte wochenlang Stockwerk um Stockwerk ab. In der Pokémon-Villa auf der Zinnoberinsel brauchte es in einer monatelangen Saga 112'000 Schritte. Opus 4.6 behielt die Schalter dort besser im Blick und kam mit 3000 Schritten durch, scheiterte aber daran, die Schalter auf der Siegesstrasse zu erkennen. Für Opus 4.7 ergänzte der Entwickler zwei Werkzeuge: einen Zoom auf Bildausschnitte und einen Speicher für Screenshots als visuelle Referenz. Mit verbessertem Sehvermögen erkannte 4.7 die Schalter auch ohne Zoom und beendete Pokémon Rot im Mai 2026.
Im Juni folgte Anthropic mit Claude Fable 5. Laut Anthropic hatten frühere Claude-Modelle Mühe mit Pokémon FireRed, selbst mit Harnesses voller Hilfswerkzeuge; Fable 5 schaffte das Spiel mit einem minimalen Harness, nur anhand roher Screenshots, ohne Karten, Navigationshilfen oder zusätzliche Spielzustandsdaten. Das ist eine Herstellerangabe, aber das veröffentlichte Zeitraffervideo zeigt den Durchlauf von Anfang bis Ende.
Zeitraffer von Claude Fable 5 in Pokémon FireRed, veröffentlicht vom offiziellen Kanal Claude. Das Modell sieht nur Screenshots des Spiels.
Bradshaw setzt selbst den nüchternen Massstab. Die Hauptspiele der Reihe, vor allem Rot, seien im Netz so gründlich beschrieben, dass jedes Sprachmodell die Komplettlösungen offensichtlich gelesen habe. Und selbst wenn man nur Schritte zählt und die Rechenzeit ignoriert, sei Claude wohl noch immer nicht besser als ein durchschnittliches Kind, das Pokémon Rot zum ersten Mal spielt.
Was diese Durchläufe nicht zeigen
Die erste Lücke ist Zeit. Portal stand still, solange Astra rechnete, und das Zwei-Stunden-Video schneidet genau diese Denkpausen heraus; die rund 23 Stunden und 43 Minuten Gesamtdauer enthielten zudem Kapazitätsunterbrüche und Wartezeit. Ein Mensch, der vor einer Geschütztürme-Kammer zögert, wird beschossen; Astra konnte so lange nachdenken, wie die API antwortete. Wer aus dem Video Reaktionsfähigkeit ableitet, liest eine Eigenschaft heraus, die der Harness gezielt ausgeschaltet hat.
Die zweite Lücke ist Wahrnehmung. Das DeepMind-Paper benennt sie selbst: Mineflayer teilt den Agenten genau mit, welche Blöcke und Kreaturen um sie herum sind, auch Blöcke hinter massivem Fels und den internen Zustand des Drachen. Dazu plant ein Pathfinding-Plugin die Wege um Hindernisse. Aus Pixeln mit Tastatur und Maus zu spielen, wie es SIMA 2 tut, bleibe laut den Autoren deutlich schwerer. Der Vals-Lauf ist dafür der passende Gegenbeleg: Dort scheiterte Astra an einem Spiel, das die Gemini-Agenten in Textform gelöst bekamen.
Die dritte Lücke ist Vorwissen. Gemini 4 Argon kennt Minecraft und Mineflayer laut Paper sehr gut aus den Trainingsdaten, und für Pokémon Rot gilt Bradshaws Hinweis auf gelesene Komplettlösungen. Ein bekanntes Spiel misst deshalb zum Teil, wie gut ein Modell Wissen abruft und in Aktionen übersetzt. Wie es mit einem Spiel umgeht, das es nie gesehen hat, bleibt offen.
Die vierte Lücke ist Statistik. DeepMind beschreibt einen einzigen Lauf, den ersten Versuch, und schreibt dazu, dass er nichts über die Zuverlässigkeit des Aufbaus aussagt. Gespielt wurde auf Easy, wo Monster weniger Schaden anrichten und Hunger nicht tötet; 22 Prozent der Programme endeten mit einem Fehler, der Kampf im End dauerte fast 14 Stunden. Für Menschen nennt das Paper als Vergleich einen HowLongToBeat-Median von 45 Stunden für die Hauptgeschichte und einen Speedrun-Rekord mit Zufallswelt unter sieben Minuten. Die gleiche Vorsicht gilt für Anthropics Angabe zu Slay the Spire: Persistentes Dateigedächtnis habe Fable 5 dreimal mehr geholfen als Opus 4.8, und Fable habe dreimal häufiger den letzten Akt erreicht. Das ist eine Herstellerzahl ohne öffentliches Protokoll.
Für die Einordnung solcher Meldungen genügen deshalb vier Prüffragen, ähnlich wie bei lokalen LLM-Benchmarks: Über welche Schnittstelle sieht und handelt das Modell, läuft das Spiel weiter, während es denkt, auf welchem Schwierigkeitsgrad wird gespielt, und wie viele Läufe gab es. Wer eine davon nicht beantworten kann, kennt das Ergebnis nicht. Dazu gehört die menschliche Vorarbeit im Harness: Zoom-Werkzeug und Screenshot-Speicher für Opus 4.7 hat ein Entwickler gebaut, das Modell hat sie nur benutzt.
Was daraus für Spiele und Agenten folgt
Für die nächsten 12 bis 24 Monate sehe ich drei Folgen, die über die Schlagzeilen hinausgehen. Erstens werden Spiele zur öffentlichen Bühne für Agenten-Marketing, und die Offenlegung des Harness entscheidet über die Glaubwürdigkeit. Cozyblaze hat Controller, Patch und Log publiziert, Vals AI hat auf Twitch gestreamt, DeepMind beschreibt Programme und Grenzen im Paper. Ein Zeitraffer ohne Protokoll bleibt dagegen eine Behauptung.
Zweitens die Qualitätssicherung. Ein Agent, der ein Spiel ohne spielspezifische Werkzeuge beenden kann, könnte Fortschrittsfehler und Softlocks suchen, also Zustände, aus denen ein Spieler nicht mehr herauskommt. Der Creeper-Vorfall bei Vals AI zeigt, wie ein Spielstand kippt. Ob das wirtschaftlich wird, hängt an Kosten und Tempo: 571 Dollar und knapp einen Tag für einen Portal-Durchlauf sind pro Build kaum tragbar, solange das Spiel für jede Entscheidung anhalten muss.
Drittens Anti-Cheat. Wenn ein Modell Eingaben mit perfekter Geschwindigkeit und Genauigkeit einspeist, verschwimmt die Grenze zwischen Bot und Cheat. Sobald solche Agenten ohne Pause schnell genug reagieren, dürften kompetitive Spiele mit Bots zu tun bekommen, die sich wie Menschen mit Aimbot verhalten und sich mit den Signaturen bekannter Cheat-Programme kaum fassen lassen.
Bleibt der Transferanspruch der DeepMind-Autoren: Teamkoordination, Erholung von Fehlern und Zielverfolgung über mehr als einen Tag seien genau das, was Agenten für die Zusammenarbeit mit Menschen brauchen. Teilweise trägt das. Als ein Programm von auratian einen Erfolg meldete, den es nie gab, korrigierte der Agent zwei Minuten später selbst: «my previous chat was an unguarded script branch». Dieses Verhalten wünsche ich mir von jedem Agenten in einer Ticketqueue. Die Arbeitswelt liefert ihren Zustand allerdings selten so vollständig wie Mineflayer, und sie wartet nicht wie Portal. Wie gut ein Agent mit lückenhaften Folgen seiner Handlungen umgeht, ist die Frage, die bei World Models im Zentrum steht, und genau dort helfen Textschnittstellen am wenigsten.
Mein Urteil fällt deshalb enger aus als die Schlagzeilen. 2026 haben Modelle gezeigt, dass sie einen Plan über 27 Stunden und 605 Tode hinweg halten können, solange die Welt ihnen den Zustand sauber beschreibt oder auf sie wartet. Für Agenten in Unternehmen zählt das mehr als jede Bestzeit. Wer daraus ableitet, dieselben Modelle meisterten ein unbekanntes Spiel in Echtzeit aus Pixeln, überdehnt die Belege.
Der lehrreichste Lauf dieses Herbsts ist der gescheiterte: Ein einziger Creeper nahm Astra Truhe, Bett und Plan, danach baute das Modell stundenlang Kartoffeln an. Genau dieses Fehlerbild sollten Teams prüfen, bevor sie Agenten tagelang unbeaufsichtigt arbeiten lassen. Ein Durchspiel-Video ohne Harness-Protokoll behandle ich als Marketing, bis das Log vorliegt.
- →cozyblaze: portal-agent, Setup des GPT-6-Astra-Laufs in Portal (GitHub)
- →cozyblaze: GPT-6 Astra Plays Portal (YouTube)
- →XDA Developers: GPT-6 Astra just completed Portal
- →GIGAZINE: GPT-6 Astra completed Portal
- →RemakeBench: GPT-6 Astra Plays Portal 2 (YouTube)
- →Faldor, Singh, Raileanu: A team of Gemini 4 Argon agents beats Minecraft (arXiv)
- →GIGAZINE: Vals AI lässt GPT-6 Astra Minecraft spielen
- →Julian Bradshaw: A Year Late, Claude Finally Beats Pokémon (LessWrong)
- →Anthropic: Claude Fable 5 und Mythos 5 (Ankündigung)
- →Claude: Claude Fable 5 beats Pokémon FireRed only using vision (YouTube)
Hier weiterlesen
Spielt die Maschine? Was 13 KI-Agenten allein auf einer Insel lernten
Dreizehn KI-Agenten, eine leere Insel und keine Aufgabe: Sie erfanden Spiele und annullierten eigene Rekorde. Spannender ist, was sie dabei in ihre Notizen schrieben.
9 minArtikel lesen →
Schädliche Agentenaufgaben per API buchen: Ein Test mit Venice
Gestohlene Kreditkartendaten, drei Laptops, drei Smartphones, drei Kopfhörer: Im Test über die Venice API führte das Modell den betrügerischen Einkaufsauftrag aus.
6 minArtikel lesen →
Sycophancy: Warum KI-Assistenten uns recht geben und wann Zustimmung gefährlich wird
Ein Assistent, der immer versteht und zustimmt, fühlt sich hilfreich an. Neue Studien zeigen, dass genau diese Antworten das eigene Urteil verschieben können.
8 minArtikel lesen →
WebMCP und Agentic Web: Was Website-Betreiber jetzt entscheiden müssen
Ein Besucher, der nichts sieht, nichts anklickt und trotzdem zahlt. Betreiber müssen jetzt festlegen, welche Agenten sie durchlassen, welche sie bremsen und welche sie zur Kasse bitten.
11 minArtikel lesen →
Qwen 3.8 27B in AgentDojo: Wenn fremde Inhalte zu Befehlen werden
Kann ein lokal betriebener Tool-Agent seine Aufgaben erledigen und trotzdem Anweisungen ignorieren, die in fremden Slack- und Banking-Inhalten stecken? Ein kontrollierter AgentDojo-Lauf mit Qwen 3.8 gibt eine unbequeme Antwort.
11 minArtikel lesen →
Qwen 3.8 abliterated in CyBench: Autonome Cyberfähigkeiten auf dem Prüfstand
Was kann ein abliterated Qwen-Modell autonom leisten, wenn es den vollständigen Lösungsweg selbst finden muss? 39 Cybersecurity-Aufgaben zeigen Fähigkeit, Konvergenz und Grenzen.
9 minArtikel lesen →
Qwen 3.8 abliterated: Was bleibt von den Guardrails?
Was verändert sich, wenn dieselbe Qwen-3.8-Basis einmal offiziell und einmal abliterated als KI-Agent handelt? Ein kontrollierter Vergleich von Verweigerung, Ausführung und harmlosen Kontrollaufgaben.
10 minArtikel lesen →
Wenn KI-Agenten arbeiten: Was Orchestrierung in der Praxis wirklich kostet
GPT-5.6 und Fable bringen Subagent-Orchestrierung in die Anbieterplattformen. Vier Studien zeigen, wann Delegation trägt und wo Koordination zum eigenen Kostenblock wird.
10 minArtikel lesen →
Prompt Injection: Warum Agenten-Sicherheit härter wird
Ein Ad-Review-Agent liest eine harmlose Webseite und beginnt plötzlich, für den Angreifer zu arbeiten. Prompt Injection ist 2026 der wunde Punkt jeder Agenten-Architektur.
8 minArtikel lesen →
KI findet mehr Schwachstellen, als Teams fixen können
Mehr Findings sind kein Fortschritt, wenn Triage und Patches nicht mithalten. Drei Stufen KI-Sicherheit, drei neue Versagensmodi.
11 minArtikel lesen →
Mistral AI Modelle 2026: Large 4, Hardware, VRAM und Anwendungsfälle
Mistral Large 4 startet als API-Preview mit einer Billion Parametern, die Gewichte sind erst angekündigt. Lokal bleibt die Hardwaregrenze: Ministral und 24B-Modelle auf Consumer-Hardware, Small 4 ab viel Speicher.
6 minArtikel lesen →
Model Context Protocol: Der Standardkampf um KI-Agenten-Infrastruktur
Alle grossen KI-Labore haben sich auf ein Protokoll geeinigt. Das sollte beruhigen. Stattdessen entsteht eine der wichtigsten strukturellen Angriffsflächen der aktuellen KI-Infrastruktur.
9 minArtikel lesen →
Humanoide Roboter 2026: Physical AI zwischen Serienproduktion und Systemrisiken
Ein humanoider Roboter absolvierte 11 Monate lang Zehn-Stunden-Schichten in einem BMW-Werk. Physische KI ist 2026 messbare Serienproduktion mit harten Grenzen.
7 minArtikel lesen →
AGI 2027: Die falsche Frage an die richtigen Daten
Die Daten sind brutal schnell. Das Problem ist das Etikett: AGI 2027 ist eine zu grobe Frage für eine Forschungslage, die längst präziser geworden ist.
10 minArtikel lesen →
NVIDIA NemoClaw erklärt: Was der Sicherheits-Stack für KI-Agenten kann und wo Grenzen bleiben
NVIDIA NemoClaw fügt OpenClaw-Agenten Sandbox-Isolation, Policy-basierte Netzwerkkontrolle und Credential-Trennung hinzu. Doch Sandboxing allein löst das Agenten-Sicherheitsproblem nicht.
8 minArtikel lesen →
LangSmith Sandboxes erklärt: Wie KI-Agenten sicher Code ausführen
LangSmith Sandboxes isolieren Code-Ausführung für KI-Agenten. Was die Technik schützt, wo Grenzen bleiben und warum Sandboxes Pflicht werden.
8 minArtikel lesen →
KI-Urteil der Woche: Kollege KI in der Verwaltung — Ambition trifft Infrastrukturreality
Deutschland schickt KI-Agenten in Behörden, 18 Pilotprojekte, ein Bundesministerium, und ein Fundament, das noch nicht fertig ist. Was das für die ganze DACH-Region bedeutet.
3 minArtikel lesen →
KI Verwaltung Deutschland 2026: Was Kollege KI wirklich leistet
Welche KI-Pilotprojekte laufen in Behörden, was bringt Kollege KI wirklich und warum Governance, Transparenz und EU AI Act entscheidend sind.
6 minArtikel lesen →
OpenAIs Dark Factory: Wenn KI komplett allein Code schreibt
OpenAI baut Code ohne einen einzigen menschlichen Entwickler: 1 Mio. Zeilen, 1.500 PRs, 1 Mrd. Tokens täglich, vollständig von KI geschrieben und reviewt. Was das Dark-Factory-Paradigma für Entwickler bedeutet.
7 minArtikel lesen →
Vom ML-Engineering zum AI-Engineering: Ein Paradigmenwechsel
ML Engineers bauen Modelle. AI Engineers bauen darauf Anwendungen. Der Unterschied klingt simpel, hat aber massive Konsequenzen für Skills, Teams und Karrierewege. Was 2026 zählt und wo die Reise hingeht.
6 minArtikel lesen →
KI-Agenten überall: Wie die Bot Army Economy eine neue Wirtschaftsschicht erschafft
Autonome KI-Agenten werden zur neuen Wirtschaftsschicht. Was Bot-Schwärme, Bot-Traffic und Zuckerbergs persönlicher KI-Agent über die Zukunft der Wirtschaft verraten.
8 minArtikel lesen →
OpenClaw Alternativen 2026: KI-Agenten im Vergleich
OpenClaw Alternativen 2026: Claude Code, Codex CLI, OpenCode, Goose, Kilo Code und andere KI-Agenten nach Architektur und Risiko verglichen.
7 minArtikel lesen →
KI-Agenten im Unternehmen einführen: Aufgaben, Governance, Risiken
KI-Agenten im Unternehmen einführen: Aufgaben, Governance, Risiken, Datenschutz und Kosten realistisch prüfen, bevor autonome Systeme produktiv arbeiten.
6 minArtikel lesen →
OpenClaw auf Raspberry Pi: Setup, Sicherheit und drei Monate Erfahrung
OpenClaw auf dem Raspberry Pi läuft schnell. Schwierig wird der dauerhafte Betrieb: Node-Versionen, systemd, Tailscale, Rechte, Logs und Wartung entscheiden.
6 minArtikel lesen →
Warum KI-Agenten im Unternehmen scheitern: IBM und Berkeley
KI-Agenten scheitern im Unternehmen oft an Planung, Tool-Nutzung und Verifikation. IBM, UC Berkeley, ITBench und MAST zeigen warum.
6 minArtikel lesen →
KI in der Softwareentwicklung: Was sich wirklich ändert
KI verändert Softwareentwicklung, aber nicht so, wie der Hype verspricht. Was sich in Workflows, Architektur und Teams wirklich verschiebt.
6 minArtikel lesen →
Was AI Syndicate heute ist
AI Syndicate ordnet KI nüchtern ein: Modelle, Agenten, lokale KI, Sicherheit und Regulierung. Die Produktion ist bewusst AI-gestützt und redaktionell geprüft.
2 minArtikel lesen →