Ein Video, in dem Wellen brechen und Licht durch Blätter fällt, zeigt zunächst, wie glaubwürdig ein Modell Bilder erzeugt. Aufschlussreicher ist ein Roboterarm in einem fremden Labor, der ein Objekt greift und an einem Zielort ablegt, weil ein Modell vorher abgeschätzt hat, wohin welche Bewegung führt. Meta hat das 2025 mit V-JEPA 2 an Franka-Armen in zwei Laboren gezeigt. Daran lässt sich der Massstab ablesen: Ein World Model wird nützlich, wenn seine Vorhersage eine Handlung oder eine kontrollierte Simulation verbessert, und Fotorealismus allein belegt das nicht.
Was World Models vorhersagen
Ein World Model lernt eine Darstellung seiner Umgebung und sagt daraus Zustände oder Veränderungen voraus. Der Begriff umfasst verschiedene Ansätze, von abstrakten Videorepräsentationen bis zu generierten 3D-Welten. Für die Handlungsplanung kommt eine Bedingung hinzu: Wenn ein Roboterarm, Fahrzeug oder eine Spielfigur eine bestimmte Aktion ausführt, wie verändert sich die Umgebung? Hier genügt eine plausibel aussehende Fortsetzung nicht. Das Modell muss die Folgen unterschiedlicher Aktionen unterscheiden.
Damit lassen sich Handlungen durchspielen, bevor sie real passieren. Ein Planer probiert im Modell mehrere Bewegungen aus, vergleicht die vorhergesagten Ergebnisse mit einem Ziel und führt die aussichtsreichste aus. Die Idee ist älter als der aktuelle Hype: Ha und Schmidhuber zeigten 2018 an Spielumgebungen, wie Agenten mit gelernten Weltmodellen handeln und sogar vollständig in deren Simulation trainieren können. Neu sind die Datenmengen und der Anspruch, aus Spielwelten in Labore, auf Strassen und in Lagerhallen zu kommen.
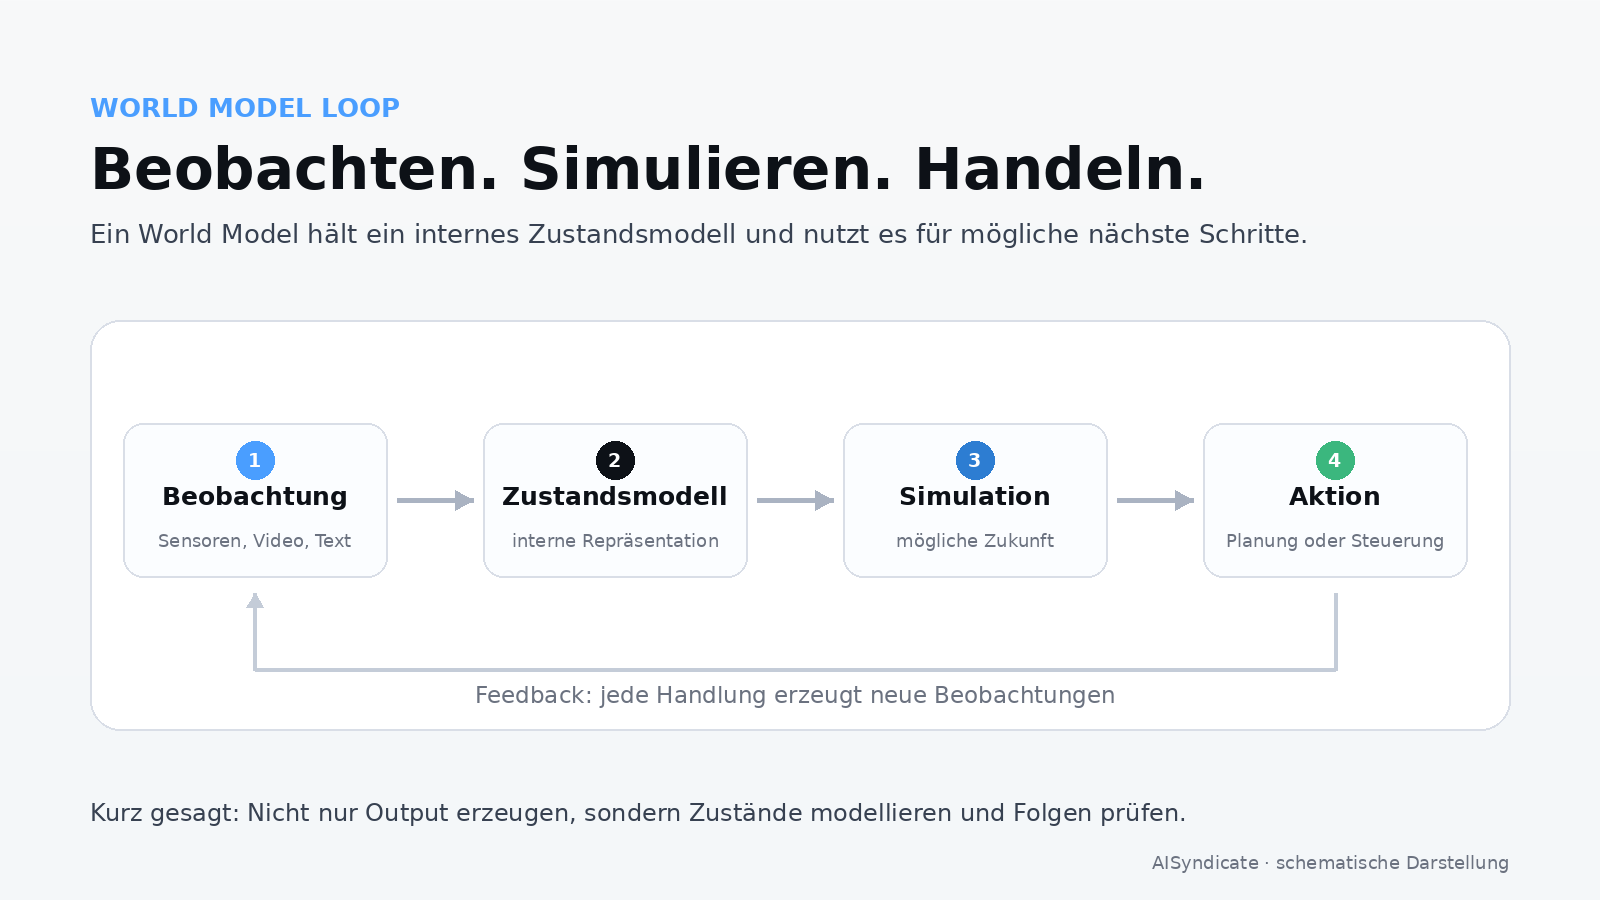
Jede Vorhersage baut auf der vorherigen auf. Kleine Fehler summieren sich deshalb, je länger ein Modell in die Zukunft rechnet; Google DeepMind nennt die Konsistenz über die Zeit eine der Hauptschwierigkeiten generierter Welten. Für Robotik und Simulation zählt deshalb, wie gut sich die Vorhersagen an realen Beobachtungen prüfen lassen.
V-JEPA 2: Planen, ohne Pixel zu malen
Meta FAIR hat V-JEPA 2 im Juni 2025 veröffentlicht. Das Basismodell lernt ohne Aktionen und ohne menschliche Labels aus Video- und Bilddaten, darunter mehr als eine Million Stunden Internetvideo. Es rekonstruiert das nächste Bild nicht Pixel für Pixel. Die JEPA-Architektur, die auf Yann LeCun zurückgeht, sagt stattdessen abstrakte Repräsentationen voraus, sodass das Modell nicht jedes unvorhersehbare Detail einer Szene nachzeichnen muss.
Für Robotik braucht es einen zweiten Schritt. Meta trainiert aus dem Basismodell ein eigenes, aktionskonditioniertes Modell namens V-JEPA 2-AC, mit weniger als 62 Stunden unbeschrifteter Robotervideos aus dem Droid-Datensatz. Erst dieses Modell verknüpft Bewegungen mit erwarteten Folgezuständen. Meta setzte es zero-shot an Franka-Armen in zwei Laboren ein, wo es Greif- und Ablegeaufgaben anhand von Zielbildern plante.
Zero-shot heisst in diesem Fall: Aus den beiden Einsatzumgebungen flossen keine Roboterdaten ins Training, und es brauchte weder aufgabenspezifisches Nachtraining noch ein dafür vorgegebenes Belohnungssignal. Roboterdaten hat das Modell also gesehen, nur keine aus diesen Laboren. Über andere Hardware, andere Aufgaben oder Dauerbetrieb sagt der Befund nichts; er stammt aus Metas eigener Studie. Wie weit der Weg von solchen Laborergebnissen zu wirtschaftlich tragfähigen Maschinen ist, zeigt der Überblick zu humanoiden Robotern und Physical AI 2026.
Genie 3 und Waymo: generierte Welten als Testgelände
Google DeepMind geht mit Genie 3 in die andere Richtung. Das Modell erzeugt aus Textbeschreibungen interaktive Umgebungen, durch die sich ein Mensch oder ein Agent in Echtzeit bewegt. Die aktuelle Modellseite nennt 20 bis 24 Bilder pro Sekunde bei 720p. Genie 3 generiert Bild für Bild aus Weltbeschreibung und Aktionen; laut DeepMind bleiben die Umgebungen mehrere Minuten weitgehend konsistent, Veränderungen durch einzelne Interaktionen erinnert das Modell bis zu einer Minute. DeepMind lässt den Agenten SIMA Aufgaben in solchen Welten lösen. Genie 3 kennt dabei das Ziel nicht und simuliert nur die Folgen der Agentenaktionen.
Die Grenzen stehen auf derselben Seite. Agenten verfügen über einen begrenzten Aktionsraum, die Interaktion mehrerer unabhängiger Agenten nennt DeepMind eine offene Forschungsfrage, reale Orte bildet das Modell nicht exakt nach, und kontinuierliche Interaktion reicht für einige Minuten. Den Web-Prototyp Project Genie startete Google im Januar 2026 für Abonnenten von Google AI Ultra in den USA; zum Start waren Generierungen auf 60 Sekunden begrenzt, und Google warnte, dass Welten nicht immer realer Physik folgen. Die Produktgrenze ist von der Modelldemo zu unterscheiden. Weder die Interaktivität noch die Bildqualität garantiert physikalisch korrekte Abläufe.
Was eine Spezialisierung ändert, zeigt Waymo. Das am 6. Februar 2026 vorgestellte Waymo World Model baut auf Genie 3 auf und wurde für den Strassenverkehr nachtrainiert. Es erzeugt Kamerabilder und zusätzlich Lidar-Daten, also die präzisen Tiefeninformationen der Laserscanner im Fahrzeug. Ingenieure steuern die Szenen über Fahraktionen, Strassenlayout und Sprachbefehle. So entstehen seltene Situationen, die sich im Flottenbetrieb kaum in grosser Zahl aufzeichnen lassen: ein Tornado, ein Elefant, ein defekter Lastwagen, der falsch herum die Fahrbahn blockiert. Über die Aktionssteuerung lassen sich auch Was-wäre-wenn-Fragen stellen, etwa ob das Fahrzeug in einer aufgezeichneten Situation sicher zügiger hätte fahren können, statt zu warten.
Das Waymo World Model ist dabei die Komponente, die simulierte Umgebungen erzeugt. Das Fahren übernimmt der Waymo Driver, das eigentliche Fahrsystem, das in diesen Welten geprüft wird. Ein bestandenes Szenario belegt deshalb, dass der Driver in einer generierten Welt richtig reagiert hat. Ob diese Welt die Wirklichkeit genau genug trifft, ist eine zweite Frage, und Sicherheit auf der Strasse ist damit nicht nachgewiesen.
Signal der Woche abonnieren
Eine Analyse pro Woche. Kein Feed, kein Alarmismus.
Kostenlos als Member. Gratis abonnieren
Cosmos 3 und Atlas: Plattformen, die Lücken füllen
Nvidia hat Cosmos 3 am 31. Mai 2026 angekündigt. Das Modell verbindet in einer Mixture-of-Transformers-Architektur visuelles Schlussfolgern, Weltgenerierung und Aktionsvorhersage. Nvidia positioniert es als Vision-Language-Modell, als World Model für Training und Evaluation und als Basis für Modelle, die Roboteraktionen erzeugen; dazu kommen Datensätze und Werkzeuge für synthetische Trainingsdaten. Nvidia nennt die über Hugging Face abrufbaren Modelle offen; die Lizenzbedingungen sind vor einem Einsatz trotzdem zu prüfen. Spitzenplätze auf Physik- und Robotik-Ranglisten sowie stark verkürzte Trainings- und Evaluationszyklen sind Nvidias eigene Angaben; eine unabhängige Bestätigung enthält die Ankündigung nicht.
World Labs hat am 1. September 2026 Atlas vorgestellt, ein multimodales autoregressives Diffusionsmodell auf Transformer-Basis. Es verarbeitet Text, Bilder, Video, Tiefenkarten und Kamerageometrie in einem gemeinsamen räumlichen Kontext. Aus wenigen Fotos erzeugt es kohärente neue Ansichten sowie explizite 3D-Ausgaben wie Punktwolken und Gaussian Splats, eine punktbasierte Darstellung für schnelles Rendern. Für Robotik soll Atlas zusätzlich die Farb- und Tiefenbilder liefern, die ein simulierter Roboter entlang seines Wegs sehen würde. Das Modell ist im Early Access für ausgewählte Partner und soll künftige Versionen des World-Labs-Produkts Marble antreiben.
Konzeptionell aufschlussreich ist ein Eingeständnis in der Ankündigung selbst. Was in den Eingabebildern nicht zu sehen ist, ergänzt Atlas mit einer plausiblen Vermutung aus seinem Weltwissen; World Labs schreibt sinngemäss, je mehr das Modell sehe, desto weniger stelle es sich vor. Für kreative Anwendungen ist das gewollt. In einer Robotersimulation wird eine solche Ergänzung zur Geometrie, mit der ein Planer rechnet, auch wenn der Türrahmen in Wirklichkeit anders sitzt. Das Muster ist von Sprachmodellen bekannt, deren Halluzinationen ebenfalls flüssige Ergänzungen dort sind, wo Belege fehlen.
World Labs und AMD: Simulation braucht Rechenleistung
Am 28. September 2026 hat World Labs eine verbindliche Vereinbarung unterzeichnet, sich AMD anzuschliessen. Vollzogen ist der Schritt noch nicht: Die Transaktion soll bis Ende 2026 abgeschlossen werden, vorbehaltlich behördlicher Genehmigungen und üblicher Vollzugsbedingungen. World Labs begründet ihn mit dem Ziel, näher an die Hardware zu rücken. Die Zusammenarbeit begann im Vorjahr mit Training und Inferenzoptimierung auf AMD-GPUs; Fei-Fei Li soll bei AMD Executive Vice President und Chief Scientist werden.
Technisch passt das ins Bild. Atlas erzeugt Bilder, Tiefenkarten und Videos autoregressiv, Element für Element. Genie 3 rechnet Bild für Bild in Echtzeit. Waymo setzt für längere Szenen eine effizientere Modellvariante ein, weil lange Simulationen nach eigener Darstellung schwerer zu berechnen und stabil zu halten sind. Wer World Models als Trainings- und Testumgebung nutzt, hängt damit am Modell, an den Simulationswerkzeugen darum herum und an der Infrastruktur, auf der beides schnell genug läuft. Nvidia bietet Partnern der Cosmos Coalition neben Modellen und Trainingswerkzeugen auch Rechenkapazität in der DGX Cloud an. AMD holt sich mit World Labs, falls der Vollzug gelingt, ein Modellteam an die eigene Hardware. Die Wahl eines World Models wird so zur Wahl der Plattform, auf der künftige Tests und Trainingsdaten entstehen.
Wie sich ein World Model prüfen lässt
Bei der Auswahl eines World Models helfen vier Prüfungen, die über den Eindruck eines Demovideos hinausgehen.
Der erste Test nutzt zurückgehaltene reale Szenen. Das Modell sagt vorher, was es nie gesehen hat, und die Vorhersage wird mit der tatsächlichen Aufnahme verglichen. Bei Atlas hiesse das: ein Foto bewusst weglassen und prüfen, ob die generierte Ansicht mit ihm übereinstimmt.
Der zweite Test prüft die Aktionssensitivität. Greift ein Roboterarm im Modell nach links statt nach rechts, muss sich die vorhergesagte Zukunft entsprechend unterscheiden. Bleibt sie fast gleich, taugt das Modell zum Rendern, kaum zum Planen.
Der dritte Test misst Drift: Wie wächst der Fehler mit der Länge des Rollouts, also mit der Zahl der nacheinander vorhergesagten Schritte? Ein Modell, das zehn Sekunden stabil bleibt und nach einer Minute Objekte verliert, gehört in kurze Planungshorizonte.
Der vierte Test betrifft seltene Ereignisse. Ein Simulator, der auf Befehl Tornados und Elefanten erzeugt, erweitert die Abdeckung. Ob die generierten Varianten der Verteilung echter Grenzfälle entsprechen, zeigt das allein nicht. Damit verlagert sich Arbeit vom Modelltraining in die Evaluation, ähnlich wie beim Wechsel vom ML- zum AI-Engineering. Diese Prüfungen beantworten unterschiedliche Fragen. Einen Sicherheitsnachweis ersetzt keine davon allein.
Wer die Testumgebung eines Anbieters übernimmt, übernimmt oft auch dessen Auswahl der Fehler, die darin überhaupt vorkommen. Ich halte deshalb jeden Simulationsbefund für unvollständig, der nicht offenlegt, auf wessen Modell und wessen Szenarienauswahl er beruht.
- Meta FAIR (Assran et al.): V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning (arXiv:2506.09985, Juni 2025)
- Google DeepMind: Genie 3, Modellseite
- Google: Project Genie: Experimenting with infinite, interactive worlds (Januar 2026)
- Waymo: The Waymo World Model: A New Frontier For Autonomous Driving Simulation (Februar 2026)
- NVIDIA: NVIDIA Launches Cosmos 3, the Open Frontier Foundation Model for Physical AI (Mai 2026)
- World Labs: Atlas: A World Model for Spatial Intelligence (September 2026)
- World Labs: World Labs is Joining AMD (September 2026)
- Ha, Schmidhuber: World Models (arXiv:1803.10122, 2018)