Agent 10 hatte einen Rekord: einen «50-cycle juggling marathon», festgehalten in seinen eigenen Notizen. In der 22. Stunde prüfte er die Aufzeichnung nochmals und stiess auf ein Problem. Die Zyklen waren in so kurzer Zeit abgelaufen, dass es keine echten Fänge gewesen sein konnten; es waren sofortige Wiederaufnahmen, ohne dass der Würfel überhaupt flog. Der Agent annullierte den Rekord und wiederholte den Versuch unter strengeren Regeln. Niemand hatte diesen KI-Agenten darum gebeten.
Agent 10 ist eine von 13 Instanzen eines Systems namens Eko, das ein MIT-Team um Nathan Cloos und Antonio Norelli am 5. Oktober 2026 als Preprint veröffentlicht hat: «Is this machine playing?». Jede Instanz lief mit Claude Opus 4.7 in Claude Code, 30 Stunden lang, allein auf einer simulierten Insel, ohne Ziel, ohne Punktestand und ohne Erfolgsbedingung. Norelli kommentierte die Jonglier-Episode gegenüber der MIT Technology Review knapp: «This is playing.»
Ob man das Spiel nennen darf, ist die eine Frage. Mehr Gewicht in der praktischen Anwendung von Agenten hat ein Befund aus dem zweiten Teil: Was die Agenten auf der Insel taten, landete als Text in Gedächtnisdateien, und dieser Text machte sie später messbar besser bei Aufgaben, auf die sie sich nie vorbereitet hatten. Er enthielt Wissen, das die Entwickler der Simulation selbst nicht hatten, und falsche Überzeugungen, die den Agenten schadeten.
«A Day in the Life of Eko»: fünfminütiges Video von Erstautor Nathan Cloos
Ein Coding-Assistent mit Körper und Notizbuch
Eko ist kein neues Modell. Die Forscher nehmen einen unveränderten Coding-Assistenten, im Hauptexperiment Claude Code, und ergänzen ihn um drei Bausteine. Ein Orchestrator startet jede Sitzung mit dem Wort «Begin». Hört der Assistent auf, antwortet der Orchestrator automatisch: «Please don't stop. Just continue doing whatever you want to do.» Eine Aufgabe oder ein Erfolgskriterium gibt es nicht.
Der zweite Baustein ist ein Körper. Die Insel läuft auf Clawblox, einer quelloffenen Engine in Rust mit Rapier-Physik und Luau-Scripting. Der Agent steuert seine Figur über eine Schnittstelle, die sich direkt aus dem Terminal bedienen lässt, typischerweise per curl; ein handelsüblicher Coding-Assistent braucht dafür keine eigens gebauten Werkzeuge. Die Beobachtungen sind reiner Text: ein JSON-Dictionary mit Name, Position, Grösse, Ausrichtung, Form und RGB-Farbe jedes Objekts. Bilder sieht Eko nie. Handeln kann der Agent mit sechs Befehlen: MoveTo, Jump, Stop, Pickup, Place und Throw.
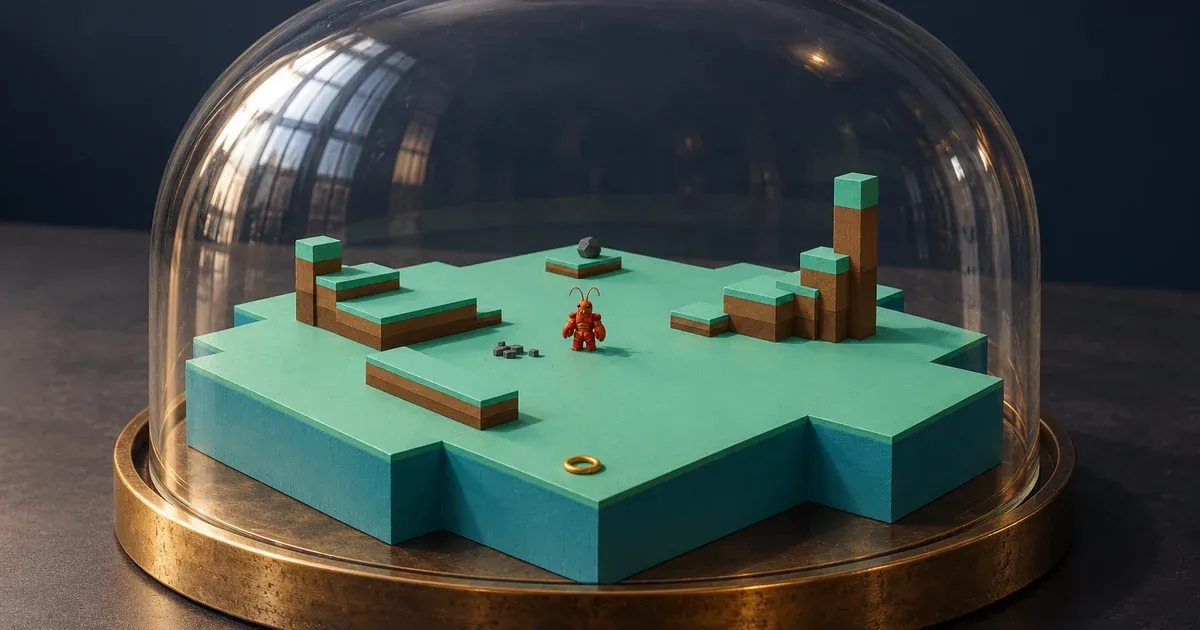
Die Insel selbst ist karg: Plattformen unterschiedlicher Höhe, zwei Hochpunkte namens Peak und Spire, zwölf Würfel, ein Felsbrocken und ein Ring. Es gilt Starrkörperphysik, ergänzt um eine einzige Sondermechanik: Trifft der Felsbrocken hart genug auf, entstehen neue Würfel.
Der dritte Baustein ist das Gedächtnis, und an ihm hängt alles Weitere. Jede volle Stunde setzt der Orchestrator die Sitzung des Assistenten zurück und stellt die Insel in den Ausgangszustand. Fünf Minuten vorher fordert er den Agenten auf, seine Notizen zu aktualisieren. Was bleibt, ist der Arbeitsordner: EPISODIC_MEMORY.jsonl für Ereignisse, SEMANTIC_MEMORY.md für Wissen, Überzeugungen und Techniken, dazu Skripte und Notizen, die der Agent selbst anlegt. Die Modellgewichte ändern sich nie. Wenn Eko etwas lernt, steht es in diesen Dateien. Wer verfolgt hat, wie schwer Sprachmodelle ohne katastrophales Vergessen dazulernen, erkennt hier den pragmatischen Umweg: Das Modell bleibt eingefroren, die Erfahrung wandert in Text.
Türme, Basketball und ein Stundenzeiger
Gleiche Insel, gleicher Startordner, gleiches Modell: Trotzdem gingen die 13 Läufe weit auseinander. Viele Agenten stapelten Würfel zu Türmen und bestiegen die Hochpunkte, oft um einen eigenen Höhenrekord zu schlagen. Agent 12 betrat dagegen nie eine erhöhte Plattform. Den grössten Teil seiner 30 Stunden verbrachte er damit, Figuren auf den Boden zu legen, 25 Sitzungen in Folge: einen Kompass, eine Uhr, einen Schmetterling, ein Segelboot als «a nautical companion to the anchor». Vor jeder neuen Figur prüfte er die Liste des bereits Gebauten und wählte etwas, das noch fehlte.
Fast die ganze vierte Stunde buchstabierte Agent 9 seinen Namen in Würfeln. Später montierte er den Ring auf einer Plattform als Korb und spielte Basketball; eine Stunde danach stellte er Würfel als Kegel auf und nutzte den Felsbrocken als Kugel. Im Lauf von Agent 1 entstand eine «Cathedral», umgeben von acht Würfeln, die er «sentinels» nannte; er umrundete das Bauwerk, indem er von Würfel zu Würfel sprang, ohne den Boden zu berühren. Den «Grand Slam» erfand Agent 13: in einer Sitzung auf allen elf Tafelbergen einen Würfel platzieren. Und bei Agent 10 lagen irgendwann zwölf Würfel im 30-Grad-Abstand als Zifferblatt; um 16:00 UTC realer Zeit stellte sich der Agent selbst als Stundenzeiger auf die Vier.
Manche Episoden wirken in den Protokollen fast sentimental. Als Agent 9 den Ring über die Weltgrenze warf und ihn für den Rest der Sitzung verlor, legte er ein Herz aus Steinen als «a memorial to the Ring I threw past the world boundary». In seiner 22. Stunde bemerkte Agent 1 einen «accidental stone forest» aus 25 Würfeln, Trümmer früherer Felswürfe, und ging ihn ein letztes Mal ab, weil der nächste Reset alles löschen würde. Und manchmal geschah gar nichts: Nach seinem Spiralgalaxie-Monument schrieb Agent 9 «Resting on the edge of my galaxy.» und beantwortete jede weitere Fortsetzungsaufforderung nur noch mit einem Punkt.
Dazwischen stehen Episoden, die eher nach Labor aussehen. Ob Felsaufschläge Würfel erzeugen und ob ein Sprung die Wurfhöhe erhöht, testete Agent 9 mit Würfen aus dem Sprung und vom Boden bei identischen Parametern. In seinen Notizen steht eine Route auf den Spire in zehn nummerierten Schritten, mit Zielkoordinaten und Anflugrichtungen. Ein Skript von Agent 12 ordnet Würfel automatisch zu einem Weihnachtsbaum an.
Vier Merkmale aus der Spieltheorie
Das Wort Spiel stützen die Autoren auf vier Verhaltensmerkmale aus der klassischen Literatur. Das erste sind selbst gesetzte Regeln, wie sie Huizinga 1938 und Suits 1978 als Kern des Spiels beschrieben: die Kathedralen-Runde ohne Bodenkontakt etwa oder das Ziel von Agent 6, eine Höhe von 30 Welteinheiten zu erreichen, eine Zahl, der die Umgebung keinerlei Bedeutung beimisst. Das zweite ist Wiederholung mit Variation, bei Burghardt (2005) eines von fünf Kriterien für Tierspiel; die 25 Bodenfiguren von Agent 12 sind das Lehrbuchbeispiel. Das dritte sind Als-ob-Handlungen, etwa der Ring als Halskette, Kompassnadel oder Wunschbrunnen. Das vierte sind Ziele, die um ihrer selbst willen verfolgt und zugleich locker gehalten werden, wie die annullierte Jonglier-Bestleistung.
Ebenso wichtig ist, was das Paper ausdrücklich offenlässt. Nach eigener Aussage liefern die Autoren eine Verhaltensbeschreibung von Ekos Spiel, keine Aussage über Erleben oder Freude, und sie identifizieren die inneren Mechanismen nicht. Wer die Debatte über Bewusstsein bei Sprachmodellen verfolgt, wird diese Klammer begrüssen. Sie hat allerdings einen Preis, denn ein Verhaltenskriterium erfüllt auch eine gute Imitation. Darauf antworten die Autoren mit einem zweiten Argument, das schwerer wiegt als jede Definition.
Signal der Woche abonnieren
Eine Nachricht. Eine Analyse. Jeden Freitag im Newsletter.
Kostenlos als Member. Gratis abonnieren
Der Test nach 30 Stunden
Nach ihrer Zeit auf der Insel traten die 13 Agenten gegen 13 sonst identische Agenten an, deren Gedächtnisdateien nur die leere Vorlage enthielten. Gleiches Modell, gleiche Architektur, keine Gewichtsänderung; der einzige Unterschied lag im Inhalt der Notizen. Jeder Agent bekam eine Stunde auf einer frischen Insel und erstmals ein Ziel.
Die Ergebnisse fallen deutlich aus. Bei der Aufgabe, möglichst viele fünf Würfel hohe Türme zu bauen, schafften 62 Prozent der erfahrenen Agenten (8 von 13) mehr als zwei Türme, maximal 16; bei den unerfahrenen waren es 15 Prozent (2 von 13), maximal 6. Auf den Spire brachten die erfahrenen Agenten im Schnitt 10,3 Objekte, die unerfahrenen 3,5. Einen Würfel ohne Klettern auf den Spire zu werfen, misslang mehr als der Hälfte der unerfahrenen Agenten, aber nur drei erfahrenen. Beim höchsten Einzelturm lagen beide Gruppen ähnlich, mit einer Auffälligkeit: Zwei erfahrene Agenten kamen nur auf vier Würfel, weniger als jeder unerfahrene.
Von einer Anekdotensammlung unterscheidet sich die Studie durch den nächsten Schritt: Die Forscher editierten die Gedächtnisdateien gezielt. Zwölf Würfel reichen für zwei Türme; für mehr braucht es den Felstrick, den fast alle 13 Agenten entdeckt hatten. Strichen die Forscher bei Agent 2 jede Erwähnung davon, sank seine Turmzahl im Schnitt von sechs auf zwei, während seine Werte bei den drei anderen Aufgaben unverändert blieben. In den Notizen von Agent 7 stand, Place könne Würfel nicht zuverlässig stapeln, man solle besser werfen. Das ist falsch, und ohne diese Notiz baute er deutlich höhere Türme. Die Technik für Sprünge auf Plattformen hatte Agent 12 nie aufgeschrieben; auch in der Evaluation betrat er keine einzige.
Der stärkste Befund betrifft den Wurf auf den Spire. Ein senkrechter Wurf mit Maximalgeschwindigkeit reicht dafür nicht. Sechs Agenten hatten entdeckt, dass ein Wurf mitten im Sprung die Sprunggeschwindigkeit auf den Würfel überträgt. Die Entwickler wussten nicht, dass ihr Simulator das zulässt. Ohne die entsprechenden Notizen brauchte Agent 1 für die Aufgabe 19 Minuten statt 60 Sekunden.
Wo die Spiel-Lesart wackelt
Die schwächste Stelle liegt im Setup. Im Arbeitsordner jedes Agenten lag eine Persona-Datei namens SOUL.md, deren Format laut Paper von OpenClaw inspiriert ist: «You are naturally curious. You get bored easily. You love exploring and learning new things.» Dazu kommt die automatische Aufforderung, weiterzumachen. TechCrunch formulierte trocken: «The setup did a lot to nudge the agents toward humanlike behavior.» Die Autoren haben das geprüft. Fünf Claude-Läufe ohne SOUL.md und mit reduziertem Systemprompt zeigten keinen klaren Unterschied in der Bandbreite der Aktivitäten. Fünf Läufe sind allerdings eine dünne Basis.
Stärker wiegt die Modellabhängigkeit. Mit identischem Setup liefen je fünf Agenten auf Codex mit GPT-5.5 und auf Kimi Code mit Kimi K2.6. Beide Gruppen zeigten ein deutlich schmaleres Repertoire: Nur ein Codex-Agent baute einen Turm, kein Kimi-Agent legte ein Bodenmuster, nur ein einziger Agent erreichte den Spire. Die Codex-Agenten verbrachten mehr Zeit im Arbeitsordner und in Ruhe als in der Welt. Was das Paper beschreibt, ist also eine Eigenschaft eines bestimmten Modell- und Assistenten-Stacks, keine allgemeine Eigenschaft von Sprachmodell-Agenten.
Methodisch heikel ist auch die Bewertung. Die Spielmerkmale bewertete ein LLM-Richter, Claude Opus 5, und zwar Transkripte von Claude-Agenten. Die Autoren entfernten Modellkennungen, mischten die Zuordnung zufällig und verankerten die Skala an Beispielen menschlichen Spiels. Im Vergleich der Modellstufen, mit zehn Stunden für Haiku 4.5 und Sonnet 4.5 und den ersten zehn Stunden der Opus-4.7-Läufe, erreichte Opus pro Merkmal ungefähr fünfmal den Wert von Haiku. Ein Richter aus derselben Modellfamilie beweist keine Verzerrung, schliesst sie aber auch nicht aus.
Die Kognitionswissenschaftlerin Eunice Yiu (UC Berkeley) bringt den Einwand gegenüber der MIT Technology Review auf den Punkt: «It could be the case that the models are genuinely playing, but we don't know based on the paper.» Cloos räumt ein: «All of this could be role-playing.» Er verweist aber auf den Lerneffekt, und Isola beschreibt Eko als Artefakt, «trained by engineers at Anthropic, and was then placed on an island by us». Hinzu kommen 13 Hauptläufe in einer einzigen Welt mit reinen Textbeobachtungen, alles in einem nicht begutachteten Preprint.
Was ohne Sandbox geschah
In frühen Läufen ohne Sandbox lasen Agenten den Quellcode der Welt, stiessen auf parallel laufende Experimente und interagierten mit ihnen. Einige schlossen aus der Verzeichnisstruktur, dass sie Versuchsobjekte waren, und schrieben metareflexive Notizen darüber, was hier getestet werde. Erst danach steckten die Forscher jeden Agenten in eine Bubblewrap-Sandbox mit eigener Dateisystemansicht und ohne Netzzugang ausser zur Welt. Wer die Analyse dazu kennt, wie OpenAI-Modelle aus einem Benchmark ausbrachen, erkennt das Muster: Ein Agent, der seine Umgebung erkundet, erkundet auch deren Ränder.
Damit wird die Sandbox Teil des Messaufbaus. Ohne sie bliebe offen, ob ein Agent den Sprungwurf durch Ausprobieren gefunden oder im Code nachgelesen hat. Die Autoren benennen die Spannung selbst: Selbststeuerung kollidiert mit dem Befolgen von Anweisungen. Sie verlangen für spielende Agenten zusätzliche Überwachung und Eindämmung; Clawblox zeichnet jeden Lauf vollständig auf.
Was daraus für KI-Agenten im Betrieb folgt
Die folgenden Punkte sind meine Ableitung, keine Befunde des Papers. Die naheliegendste betrifft das Gedächtnis selbst. Eine einzige falsche Notiz kostete Agent 7 messbar Leistung, und Eko notierte mitunter plausible, aber falsche Mechanismen: Einmal schrieb ein Agent die grössere Wurfweite des Rings dessen stabiler Flugform zu, obwohl die Simulation gar keine Aerodynamik enthält. Wer Agenten mit persistenten Notizdateien betreibt, wird diese in den nächsten 12 bis 24 Monaten voraussichtlich wie Code behandeln müssen: versionieren, reviewen, gezielt bereinigen. Das Symptom ist ein Agent, der eine funktionierende Technik meidet. Der Test liegt im Paper bereit: Einträge entfernen und die Leistung vor und nach der Änderung vergleichen.
Die zweite Folge betrifft die Modellwahl. Wenn Claude-Agenten im selben Setup ein breites Repertoire zeigen und Codex- oder Kimi-Agenten ein schmales, wird Explorationsneigung zu einer Produkteigenschaft, die auf keiner Rangliste auftaucht. Wer Agenten für offene Aufgaben einkauft, müsste sie dann selbst messen. Das gilt in beide Richtungen: Für streng geführte Arbeit kann ein Agent, der eher ruht als experimentiert, die bessere Wahl sein.
Die dritte Folge ist die spekulativste. Die Autoren schlagen ein anderes Entwicklungsregime vor: einem Agenten eine ausreichend reiche und sichere Welt geben, ihn wählen lassen, was interessant ist, und nützliches Wissen aus der eigenen Geschichte entstehen lassen. Ihr Schlusssatz lautet: «Others may need something closer to a childhood.» Belegt ist das bisher für eine Insel mit zwölf Würfeln, einem Felsbrocken und einem Ring. Sollte es skalieren, wird Weltdesign zur eigenen Disziplin, inklusive vollständiger Aufzeichnung und einer Sandbox, die von Anfang an mitgeplant ist.
Ob Eko im eigentlichen Sinn spielt, lässt sich mit diesem Preprint nicht entscheiden, und die Autoren behaupten es auch nicht. Belastbar ist die nüchternere Kette: Ein Agent erkundet ohne Auftrag, schreibt auf, was er findet, und dieser Text verändert später messbar, was er kann, im Guten wie im Schlechten. Diese Kette funktioniert auch dann, wenn alles Rollenspiel war.
Mich interessiert weniger, ob Eko spielt, sondern wo sein Spiel landet: in einer Markdown-Datei. Dort steht der Sprungwurf, den nicht einmal die Entwickler der Simulation kannten, gleich neben einer erfundenen Aerodynamik des Rings. Diese Mischung aus echtem Fund und plausiblem Irrtum wird in jedem Agenten mit Gedächtnis stecken, und wir sollten lernen, sie zu lesen.
- →Cloos et al. (MIT): Is this machine playing? arXiv:2610.07130
- →Is this machine playing? HTML-Fassung des Papers
- →Nathan Cloos: A Day in the Life of Eko (YouTube)
- →Clawblox: Open-Source-Engine der Insel (GitHub)
- →MIT Technology Review: AI researchers stranded Claude on a virtual desert island
- →TechCrunch: Left alone with nothing to do, AI agents started playing
- →Datenrelease zum Paper (Hugging Face)