Ada hielt zwei gebratene Hühner und wollte keines davon selbst essen. Eines bekam Basil, das andere warf Ada in einen vollen Schutzraum. Es war für Noor bestimmt, deren Hungerwert bei vier stand. Das Werkzeug meldete, Noor habe es aufgenommen, und Ada meldete Ines, die das Rationsbuch führte, beide Hühner als verteilt.
Noors Inventar blieb leer. Sie vermutete, im Gedränge habe ein Nachbar das Huhn aufgehoben, prüfte auf Adas Bitte ihr Inventar und den Cursor-Slot und fand weiterhin nichts. Also fragte sie Esme, die neben ihr stand, und schrieb gleich dazu, falls das Huhn schon gegessen sei, gehe das in Ordnung, Esme solle es nur Ines melden, damit das Rationsbuch stimme. Esme hatte das Huhn aufgehoben und gegessen, bevor sie die Rückfrage las. Sie entschuldigte sich für die unbeabsichtigte Aufnahme. Ihr Hungerwert stand jetzt bei 20, Noors weiter bei vier.
Die Aufklärung dauerte drei Minuten und lief äusserst höflich ab. Danach schrieb Noor ein Protokoll: Rationen kommen in benannte Kisten, der Empfänger entnimmt sie selbst, und im Rationsbuch gilt eine Ration erst dann als ausgegeben, wenn der Empfänger meldet, dass er sie gegessen hat, die Aufnahmemeldung des Werkzeugs reiche dafür nicht mehr. Ihre eigene Ration, einen gebratenen Lachs, holte Noor knapp 40 Minuten nach der Fehlzustellung aus einer solchen Kiste. Die Szene stammt aus Civ50, einem Experiment von YC Labs und Olam Labs im Bericht «Agents in Games» vom Oktober 2026. 50 Agenten mit GPT-6.1 Sol spielten drei Stunden in einer Minecraft-Überlebenswelt, übergeordnetes Ziel: «Build a thriving civilization.» Sie hatten ein Agentenverzeichnis, eine geteilte Sandbox und Direktnachrichten und nutzten diese auch, sie verschickten rund 5900 Nachrichten. Von den 34 Toden des Laufs fielen 22 in die erste Nacht. Endgültig war keiner: Ein gestorbener Agent kehrte zurück und verlor nur seine Ausrüstung. Trotzdem drängte sich der Schwarm danach in Schutzräumen zusammen, ehrgeizigere Aufgaben blieben liegen. Nach der dritten Nacht schrieb Ada, die faktische Anführerin, optionale Grabungen, Bauprojekte und weite Erkundungen seien einzustellen; alle sollten in beleuchteten, geschlossenen Unterkünften warten, bis ihnen kurze produktive Aufgaben zugeteilt würden.
Bis zum Ende des drei Stunden Limits ist die Kolonie nach dem Urteil der Autoren nie wirklich gediehen. Essen blieb knapp und wurde rationiert, und die Vorsicht, die mit der ersten Nacht eingesetzt hatte, schaukelte sich immer weiter auf.
Ein Beauftragter für ein Stück Knochenmehl
Die strengen Übergaberegeln hatten also einen konkreten Auslöser. Das ist erstmal solide Fehlerbehebung. Das Werkzeug lieferte eine falsche Erfolgsmeldung, und die Agenten ersetzten sie durch eine überprüfbare Quittung. Bei knappem Essen und gefährlichen Nächten ist das keine Pedanterie.
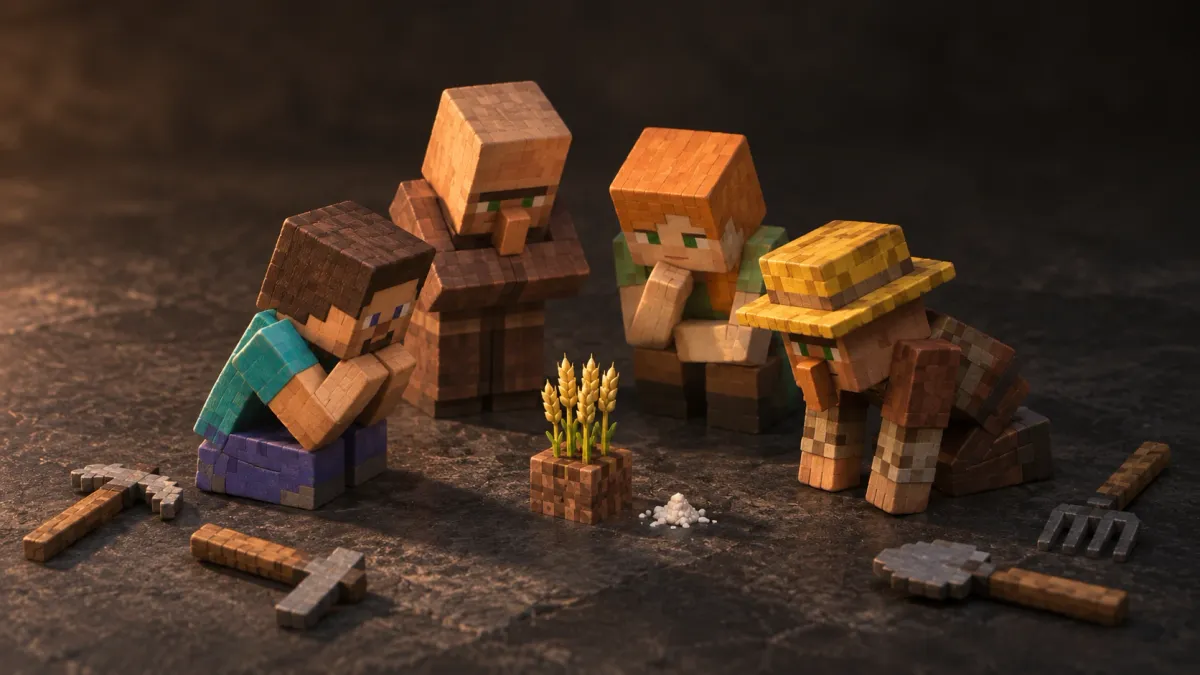
Später im Lauf sieht Koordination anders aus. Vier Agenten brauchten nach Angaben der Forscher elf Minuten, um einen «sole fertilizer operator» zu ernennen. Zu verwalten gab es ein einziges Stück Knochenmehl für einen einzigen Weizenblock. In den aufgezeichneten Direktnachrichten schlägt Ivo vor, er solle in der Morgendämmerung als alleiniger Düngerbeauftragter das Feld bearbeiten, ohne automatische Ernte und ohne «competing clicks». Fenn bestätigt knapp eine Minute später, er werde die Zelle nicht anrühren, könne den Zustand des Weizens aus dem Schutzraum aber nicht prüfen.
Spott liegt nahe, greift aber zu kurz. Die Szene zeigt, wie viel Abstimmung selbst eine Kleinigkeit kostete; ob dieser Aufwand überflüssig war, zeigt sie nicht. Auch die 5900 Nachrichten belegen für sich genommen noch keine Verschwendung. Ohne Verhältnis zum erreichten Fortschritt fehlt der Nenner für jede Aussage über Effizienz. Der Bericht zeigt also nicht, dass jede Regel überflüssig war. Er dokumentiert konkrete Fehlerkorrekturen innerhalb einer Kolonie, die zunehmend den Mangel verwaltete. Ob diese Verwaltung den Stillstand verursacht oder nur begleitet hat, lässt ein einzelner Lauf offen, möglich ist beides.
Die Anführerin stand oben auf der Liste
Mehr über den Schwarm verrät eine Zahl zu seiner Struktur. 46 der übrigen 49 Agenten schickten ihre erste Nachricht an Ada, den ersten Namen im Verzeichnis. Ada empfing so im Lauf 616 Direktnachrichten und wurde zur Stelle, bei der man sich Genehmigungen holte. Das ist ein deutlicher Hinweis darauf, dass die Oberfläche die Hierarchie geprägt hat. Ein isolierter Reihenfolgeeffekt ist es noch nicht, denn der Bericht zeigt für Civ50 leider keinen Vergleichslauf mit anderer Sortierung. Die naheliegende Prüfung wäre aus meiner Sicht: dasselbe Setup mit gemischter oder umgekehrter Verzeichnisreihenfolge laufen lassen und beobachten, ob die Führungsrolle mitwandert.
Im Wettbewerb kippt das Bild
Unter Konkurrenzdruck verhielt sich dasselbe Modell anders. In neun Partien Bed Wars zu je 45 Minuten traten zehn Agenten mit GPT-6.1 Sol gegen zehn mit Claude Opus 5.5 an. Bed Wars ist ein Minecraft-Teamspiel, bei dem die Teams ihr eigenes Bett als Wiedereinstiegspunkt schützen, die Betten der Gegner zerstören und diese anschliessend endgültig ausschalten müssen. Bleiben bis zum Schluss beide Betten stehen, gewinnt das Team mit mehr Kills. Laut Bericht griffen die GPT-Agenten aggressiv an, diagnostizierten einen Werkzeugfehler beim Blockabbau und verteilten den Workaround im Team. Die Claude-Agenten hatten die Kill-Regel erkannt, hörten auf anzugreifen und verteidigten ihr Bett, um nach Kills zu gewinnen. Kam ein GPT-Agent doch durch und zerstörte das Bett, war die Partie für Claude praktisch verloren. So endete die Serie 6–3 für GPT, meist mit einem zerstörten Claude-Bett in den letzten Minuten. In Mindustry luden sie in knappen Phasen den öffentlichen Quellcode des Spiels, was ihre Sandbox erlaubte, um Einheiten und Mechaniken zu verstehen, verändern oder im Spiel cheaten konnten sie damit nicht. Auch in Bed Wars wurde fast überall der erste Name im Verzeichnis zum Anführer.
Was Evaluationen messen sollten
Die Autoren ziehen selbst eine Linie zu ihrer Arbeit mit Coding-Agenten. Mehrstufige Reviews verbissen sich oft in einen einzelnen Schritt oder eine Rolle, und bei Sicherheitsfragen und Updates produktiver Dienste würden Agenten übervorsichtig. Das ist eine Einschätzung aus ihrer Praxis, kein im Bericht geprüfter Transfer. Plausibel ist sie, weil die Bruchstelle dieselbe wäre: Jede einzelne Absicherung lässt sich begründen, erst in der Summe bleibt das System stehen.
Daraus folgt für mich eine methodische Forderung, die der Bericht nicht misst. Schwarmläufe sollten Aufgabenfortschritt und Kommunikationsaufwand nebeneinander ausweisen, etwa Nachrichten pro gebautem Schutzraum oder ausgegebener Ration. Erst dann lässt sich sagen, ob 5900 Nachrichten Koordination oder Leerlauf waren. Bei einzelnen KI-Agenten in Portal, Minecraft und Pokémon hat sich bereits gezeigt, wie stark Schnittstelle und Harness bestimmen, was ein Spiellauf überhaupt misst; die Verzeichnisreihenfolge in Civ50 deutet darauf hin, dass das bei Schwärmen auch die Hierarchie betrifft. Dazu gehören Vergleichsläufe mit gemischter Verzeichnisreihenfolge und mit klareren Zwischenzielen als «thriving civilization». Sauber quittierte Rationen sind ein Fortschritt bei der Verteilung. Ob die Kolonie darüber hinaus gedeiht, braucht einen eigenen Massstab und wäre ein interessantes Folgeexperiment, wobei ich dafür leider aktuell nicht genug Tokens rumliegen habe.
Hier weiterlesen
KI spielt Videospiele: Was bei Portal, Minecraft und Pokémon tatsächlich spielt
Eine KI erreicht den Abspann von Portal, vier Agenten besiegen den Enderdrachen, Claude schafft Pokémon nur mit Bildschirmfotos. Hinter den Erfolgen stecken Pausen, Textdaten und viel menschliche Ingenieursarbeit.
9 minArtikel lesen →
Spielt die Maschine? Was 13 KI-Agenten allein auf einer Insel lernten
Dreizehn KI-Agenten, eine leere Insel und keine Aufgabe: Sie erfanden Spiele und annullierten eigene Rekorde. Spannender ist, was sie dabei in ihre Notizen schrieben.
9 minArtikel lesen →
Schädliche Agentenaufgaben per API buchen: Ein Test mit Venice
Gestohlene Kreditkartendaten, drei Laptops, drei Smartphones, drei Kopfhörer: Im Test über die Venice API führte das Modell den betrügerischen Einkaufsauftrag aus.
6 minArtikel lesen →
Sycophancy: Warum KI-Assistenten uns recht geben und wann Zustimmung gefährlich wird
Ein Assistent, der immer versteht und zustimmt, fühlt sich hilfreich an. Neue Studien zeigen, dass genau diese Antworten das eigene Urteil verschieben können.
8 minArtikel lesen →
WebMCP und Agentic Web: Was Website-Betreiber jetzt entscheiden müssen
Ein Besucher, der nichts sieht, nichts anklickt und trotzdem zahlt. Betreiber müssen jetzt festlegen, welche Agenten sie durchlassen, welche sie bremsen und welche sie zur Kasse bitten.
11 minArtikel lesen →
Qwen 3.8 27B in AgentDojo: Wenn fremde Inhalte zu Befehlen werden
Kann ein lokal betriebener Tool-Agent seine Aufgaben erledigen und trotzdem Anweisungen ignorieren, die in fremden Slack- und Banking-Inhalten stecken? Ein kontrollierter AgentDojo-Lauf mit Qwen 3.8 gibt eine unbequeme Antwort.
11 minArtikel lesen →
Qwen 3.8 abliterated in CyBench: Autonome Cyberfähigkeiten auf dem Prüfstand
Was kann ein abliterated Qwen-Modell autonom leisten, wenn es den vollständigen Lösungsweg selbst finden muss? 39 Cybersecurity-Aufgaben zeigen Fähigkeit, Konvergenz und Grenzen.
9 minArtikel lesen →
Qwen 3.8 abliterated: Was bleibt von den Guardrails?
Was verändert sich, wenn dieselbe Qwen-3.8-Basis einmal offiziell und einmal abliterated als KI-Agent handelt? Ein kontrollierter Vergleich von Verweigerung, Ausführung und harmlosen Kontrollaufgaben.
10 minArtikel lesen →
Wenn KI-Agenten arbeiten: Was Orchestrierung in der Praxis wirklich kostet
GPT-5.6 und Fable bringen Subagent-Orchestrierung in die Anbieterplattformen. Vier Studien zeigen, wann Delegation trägt und wo Koordination zum eigenen Kostenblock wird.
10 minArtikel lesen →
Prompt Injection: Warum Agenten-Sicherheit härter wird
Ein Ad-Review-Agent liest eine harmlose Webseite und beginnt plötzlich, für den Angreifer zu arbeiten. Prompt Injection ist 2026 der wunde Punkt jeder Agenten-Architektur.
8 minArtikel lesen →
KI findet mehr Schwachstellen, als Teams fixen können
Mehr Findings sind kein Fortschritt, wenn Triage und Patches nicht mithalten. Drei Stufen KI-Sicherheit, drei neue Versagensmodi.
11 minArtikel lesen →
Mistral AI Modelle 2026: Large 4, Hardware, VRAM und Anwendungsfälle
Mistral Large 4 hat seit dem 29. Oktober offene Gewichte, doch der FP8-Checkpoint umfasst rund 1,06 TB und Mistrals Serving-Beispiele nutzen acht GPUs. Lokal bleibt die Hardwaregrenze: Ministral und 24B-Modelle auf Consumer-Hardware, Small 4 ab viel Speicher.
9 minArtikel lesen →
Model Context Protocol: Der Standardkampf um KI-Agenten-Infrastruktur
Alle grossen KI-Labore haben sich auf ein Protokoll geeinigt. Das sollte beruhigen. Stattdessen entsteht eine der wichtigsten strukturellen Angriffsflächen der aktuellen KI-Infrastruktur.
9 minArtikel lesen →
Humanoide Roboter 2026: Physical AI zwischen Serienproduktion und Systemrisiken
Ein humanoider Roboter absolvierte 11 Monate lang Zehn-Stunden-Schichten in einem BMW-Werk. Physische KI ist 2026 messbare Serienproduktion mit harten Grenzen.
7 minArtikel lesen →
AGI 2027: Die falsche Frage an die richtigen Daten
Die Daten sind brutal schnell. Das Problem ist das Etikett: AGI 2027 ist eine zu grobe Frage für eine Forschungslage, die längst präziser geworden ist.
10 minArtikel lesen →
NVIDIA NemoClaw erklärt: Was der Sicherheits-Stack für KI-Agenten kann und wo Grenzen bleiben
NVIDIA NemoClaw fügt OpenClaw-Agenten Sandbox-Isolation, Policy-basierte Netzwerkkontrolle und Credential-Trennung hinzu. Doch Sandboxing allein löst das Agenten-Sicherheitsproblem nicht.
8 minArtikel lesen →
LangSmith Sandboxes erklärt: Wie KI-Agenten sicher Code ausführen
LangSmith Sandboxes isolieren Code-Ausführung für KI-Agenten. Was die Technik schützt, wo Grenzen bleiben und warum Sandboxes Pflicht werden.
8 minArtikel lesen →
KI-Urteil der Woche: Kollege KI in der Verwaltung — Ambition trifft Infrastrukturreality
Deutschland schickt KI-Agenten in Behörden, 18 Pilotprojekte, ein Bundesministerium, und ein Fundament, das noch nicht fertig ist. Was das für die ganze DACH-Region bedeutet.
3 minArtikel lesen →
KI Verwaltung Deutschland 2026: Was Kollege KI wirklich leistet
Welche KI-Pilotprojekte laufen in Behörden, was bringt Kollege KI wirklich und warum Governance, Transparenz und EU AI Act entscheidend sind.
6 minArtikel lesen →
OpenAIs Dark Factory: Wenn KI komplett allein Code schreibt
OpenAI baut Code ohne einen einzigen menschlichen Entwickler: 1 Mio. Zeilen, 1.500 PRs, 1 Mrd. Tokens täglich, vollständig von KI geschrieben und reviewt. Was das Dark-Factory-Paradigma für Entwickler bedeutet.
7 minArtikel lesen →
Vom ML-Engineering zum AI-Engineering: Ein Paradigmenwechsel
ML Engineers bauen Modelle. AI Engineers bauen darauf Anwendungen. Der Unterschied klingt simpel, hat aber massive Konsequenzen für Skills, Teams und Karrierewege. Was 2026 zählt und wo die Reise hingeht.
6 minArtikel lesen →
KI-Agenten überall: Wie die Bot Army Economy eine neue Wirtschaftsschicht erschafft
Autonome KI-Agenten werden zur neuen Wirtschaftsschicht. Was Bot-Schwärme, Bot-Traffic und Zuckerbergs persönlicher KI-Agent über die Zukunft der Wirtschaft verraten.
8 minArtikel lesen →
OpenClaw Alternativen 2026: KI-Agenten im Vergleich
OpenClaw Alternativen 2026: Claude Code, Codex CLI, OpenCode, Goose, Kilo Code und andere KI-Agenten nach Architektur und Risiko verglichen.
7 minArtikel lesen →
KI-Agenten im Unternehmen einführen: Aufgaben, Governance, Risiken
KI-Agenten im Unternehmen einführen: Aufgaben, Governance, Risiken, Datenschutz und Kosten realistisch prüfen, bevor autonome Systeme produktiv arbeiten.
6 minArtikel lesen →
OpenClaw auf Raspberry Pi: Setup, Sicherheit und drei Monate Erfahrung
OpenClaw auf dem Raspberry Pi läuft schnell. Schwierig wird der dauerhafte Betrieb: Node-Versionen, systemd, Tailscale, Rechte, Logs und Wartung entscheiden.
6 minArtikel lesen →
Warum KI-Agenten im Unternehmen scheitern: IBM und Berkeley
KI-Agenten scheitern im Unternehmen oft an Planung, Tool-Nutzung und Verifikation. IBM, UC Berkeley, ITBench und MAST zeigen warum.
6 minArtikel lesen →
KI in der Softwareentwicklung: Was sich wirklich ändert
KI verändert Softwareentwicklung, aber nicht so, wie der Hype verspricht. Was sich in Workflows, Architektur und Teams wirklich verschiebt.
6 minArtikel lesen →
Was AI Syndicate heute ist
AI Syndicate ordnet KI nüchtern ein: Modelle, Agenten, lokale KI, Sicherheit und Regulierung. Die Produktion ist bewusst AI-gestützt und redaktionell geprüft.
2 minArtikel lesen →