Auf veloGB10 bin ich im NVIDIA Developer Forum gestossen, im Release-Thread zu v0.7.0. Hängen geblieben bin ich an den Decode-Zahlen: Für ein Modell mit 125 Milliarden Parametern lagen sie auf einer einzelnen DGX Spark deutlich über dem, was ich bei dieser Grösse auf dem Gerät bisher gesehen hatte. Also habe ich es auf meinem ASUS Ascent GX10 nachgemessen.
Was veloGB10 ist
veloGB10 ist kein Modell und auch kein weiteres Startrezept für vLLM. Es ist eine eigenständige Inferenz-Engine, die Stav Katsoulis als Ein-Personen-Projekt von Grund auf in Rust und CUDA schreibt. Sie zielt auf genau eine Hardware: Systeme mit NVIDIA GB10, also DGX Spark und kompatible OEM-Geräte. Unterstützt wird eine handverlesene Modellauswahl, derzeit die Qwen-Familien 3.5, 3.6 und 3.8 sowie Tencent Hy3.
Der Unterschied zu bekannten Stacks liegt im Zuschnitt. vLLM ist auf breites Serving gebaut: mehr als 200 Modellarchitekturen, viele Beschleunigertypen und Continuous Batching für viele parallele Anfragen. llama.cpp setzt auf minimales Setup und läuft vom Mac bis zur CUDA-Karte. Beide bringen eigene, stark optimierte Kernels mit. veloGB10 verzichtet bewusst auf diese Breite. Dafür bekommt jede unterstützte Modellfamilie eigene Rechenpfade für GB10, und komprimierte EXL3-Gewichte werden direkt geladen, ohne Umweg über ein anderes Format. EXL3 ist das Quantisierungsformat von ExLlamaV3: Es speichert die gelernten Zahlenwerte eines Modells – seine Gewichte – mit weniger Bits und reduziert so den Speicherbedarf. EXL3-Gewichte sind also eine komprimierte Fassung der Modellparameter, kein eigenes Modell. Dazu kommt eine eingebaute spekulative Dekodierung über den MTP-Head des Modells, deren Tiefe die Engine automatisch wählt.
Das Prinzip lässt sich einfach erklären. Ein kleiner Zusatzhead schlägt mehrere nächste Tokens auf einmal vor. Das grosse Modell prüft diese Kandidaten gemeinsam in einem Durchgang und übernimmt nur, was es selbst auch erzeugt hätte. Ein unbestätigter Vorschlag gelangt nie in die Ausgabe. Laut Dokumentation ist die Ausgabe bei Greedy-Decoding bitgenau identisch mit einem Lauf ohne Spekulation, beim Sampling folgt sie derselben Verteilung. Tempo gewinnt die Engine immer dann, wenn viele Vorschläge passen.
Das getestete Setup
Getestet habe ich Qwen3.8-Flash-Next vom Qwen-Team, ein Mixture-of-Experts-Modell mit 125 Milliarden Parametern, von denen pro Token rund sechs Milliarden aktiv sind. Es lief als EXL3-Pack mit 3,05 bpw, quantisiert von turboderp und verteilt von doth4580. Den EXL3-Pfad führt Katsoulis auf das DGX-Spark-Rezept von vcruz305 zurück. Engine und Setup sind im Repository zu veloGB10 v0.7.3 dokumentiert. Gemessen habe ich am 10. Oktober 2026 auf meinem GX10 mit GB10 und 128 GB Unified Memory, auf einer einzelnen Maschine.
Als Vergleich dient mein früheres Profil desselben Modells: Hybrid-Sharp in NVFP4/FP8 mit MTP2 auf vLLM, gemessen im September. Datum, Quantisierung und Runtime unterscheiden sich. Die Gegenüberstellung zeigt deshalb zwei reale Setups und keinen isolierten Engine-Effekt. Gemessen habe ich mit llama-benchy. Die Grafiken trennen die vergleichbare kurze Testform von den historischen Langkontext-Messungen.
Decode: im kurzen Test rund doppelt so schnell
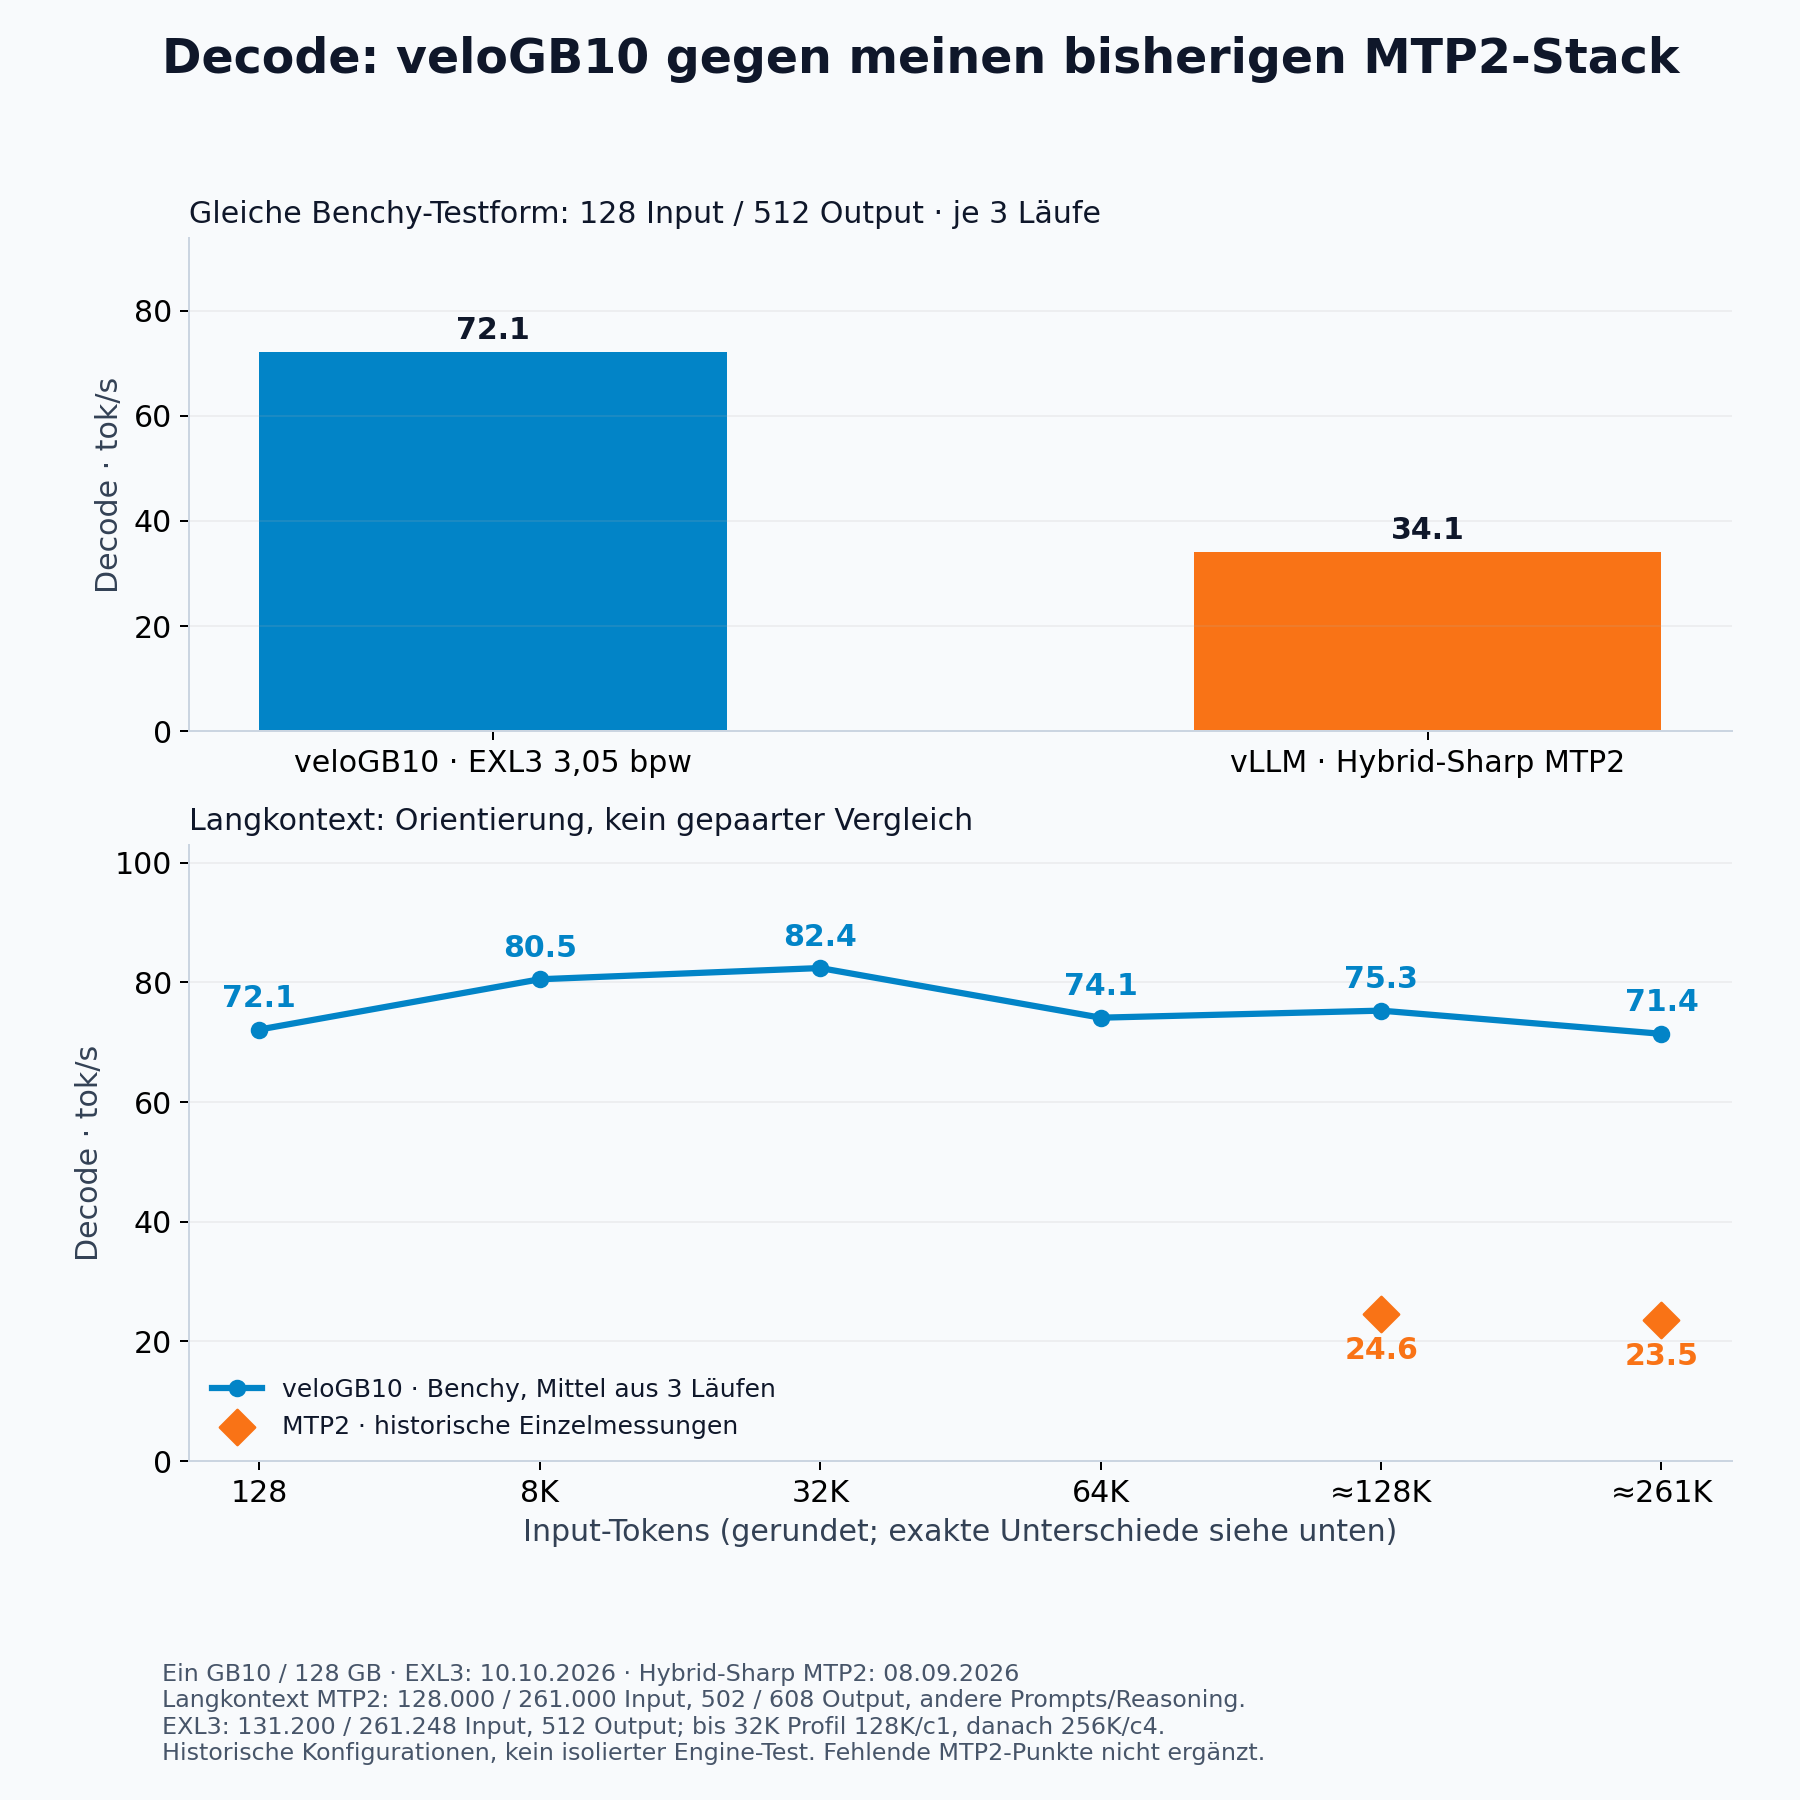
Kurztest: je drei Läufe. Langkontext: EXL3-Mittelwerte und historische MTP2-Einzelmessungen mit anderen Prompts.
Im kurzen Test lieferte veloGB10 mit 72,1 statt 34,1 tok/s rund den doppelten Decode-Durchsatz. Auch bei langen Prompts blieb EXL3 schnell. Die historischen MTP2-Punkte stammen dort jedoch aus anderen Prompts, mit anderer Ausgabelänge und je einem Lauf.
Signal der Woche abonnieren
Eine Nachricht. Eine Analyse. Jeden Freitag im Newsletter.
Kostenlos als Member. Gratis abonnieren
TTFT: Lange Prompts brauchen Vorlauf
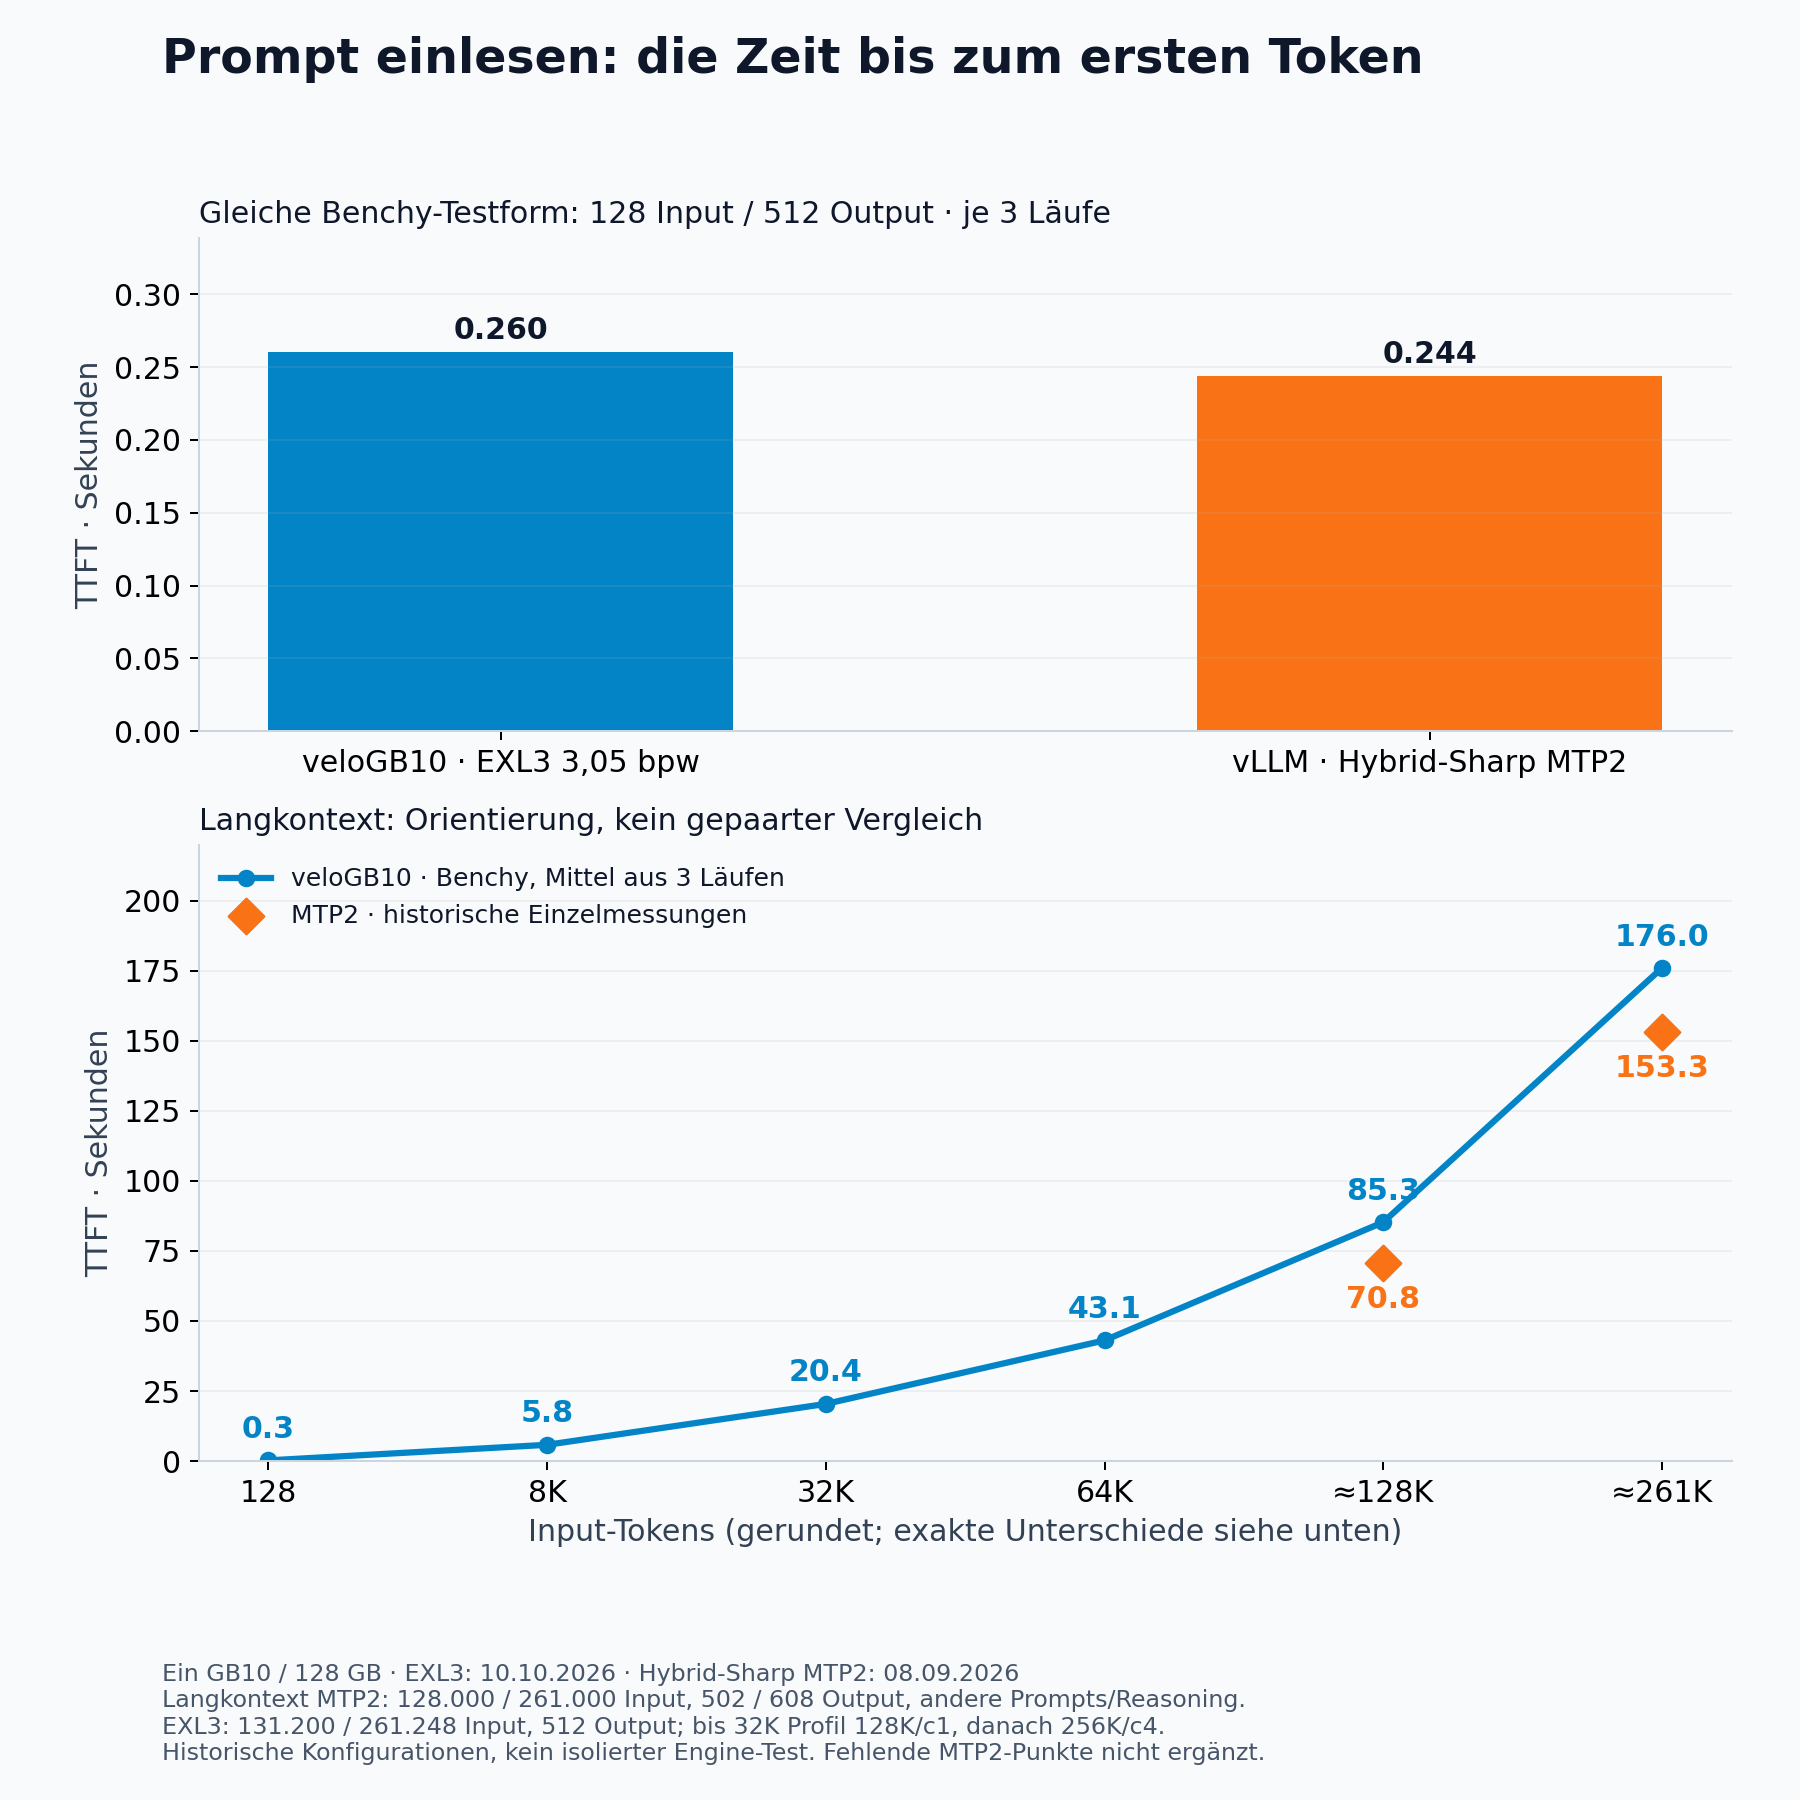
EXL3: je drei Läufe. MTP2: gleicher Kurztest, historische Langkontext-Werte mit anderen Prompts.
Die Zeit bis zum ersten Token (TTFT) misst die Wartezeit bis zum Antwortbeginn, hier mit kaltem Prompt. Kurz liegen beide Setups fast gleichauf. Bei 128K wartete ich auf veloGB10 rund 85 Sekunden, nahe dem Limit knapp drei Minuten. Die historischen MTP2-Werte lagen leicht darunter, allerdings mit anderen prompts, also ist auch hier kein absoluter Vergleich möglich. Schneller Decode beseitigt diese Wartezeit nicht; eine lange TTFT allein belegt aber auch keinen schwachen Prefill. Eine Prefill-Rate weise ich bewusst nicht aus, weil früh gesendete HTTP-Header die Prefill-Metrik von Benchy bei veloGB10 verfälschen. Vier gleichzeitige kalte Anfragen mit 128K arbeitete die Engine gestaffelt ab, im Mittel mit 212,5 Sekunden bis zum ersten Token.
Hardmode: leichte Abstriche beim Tool-Calling
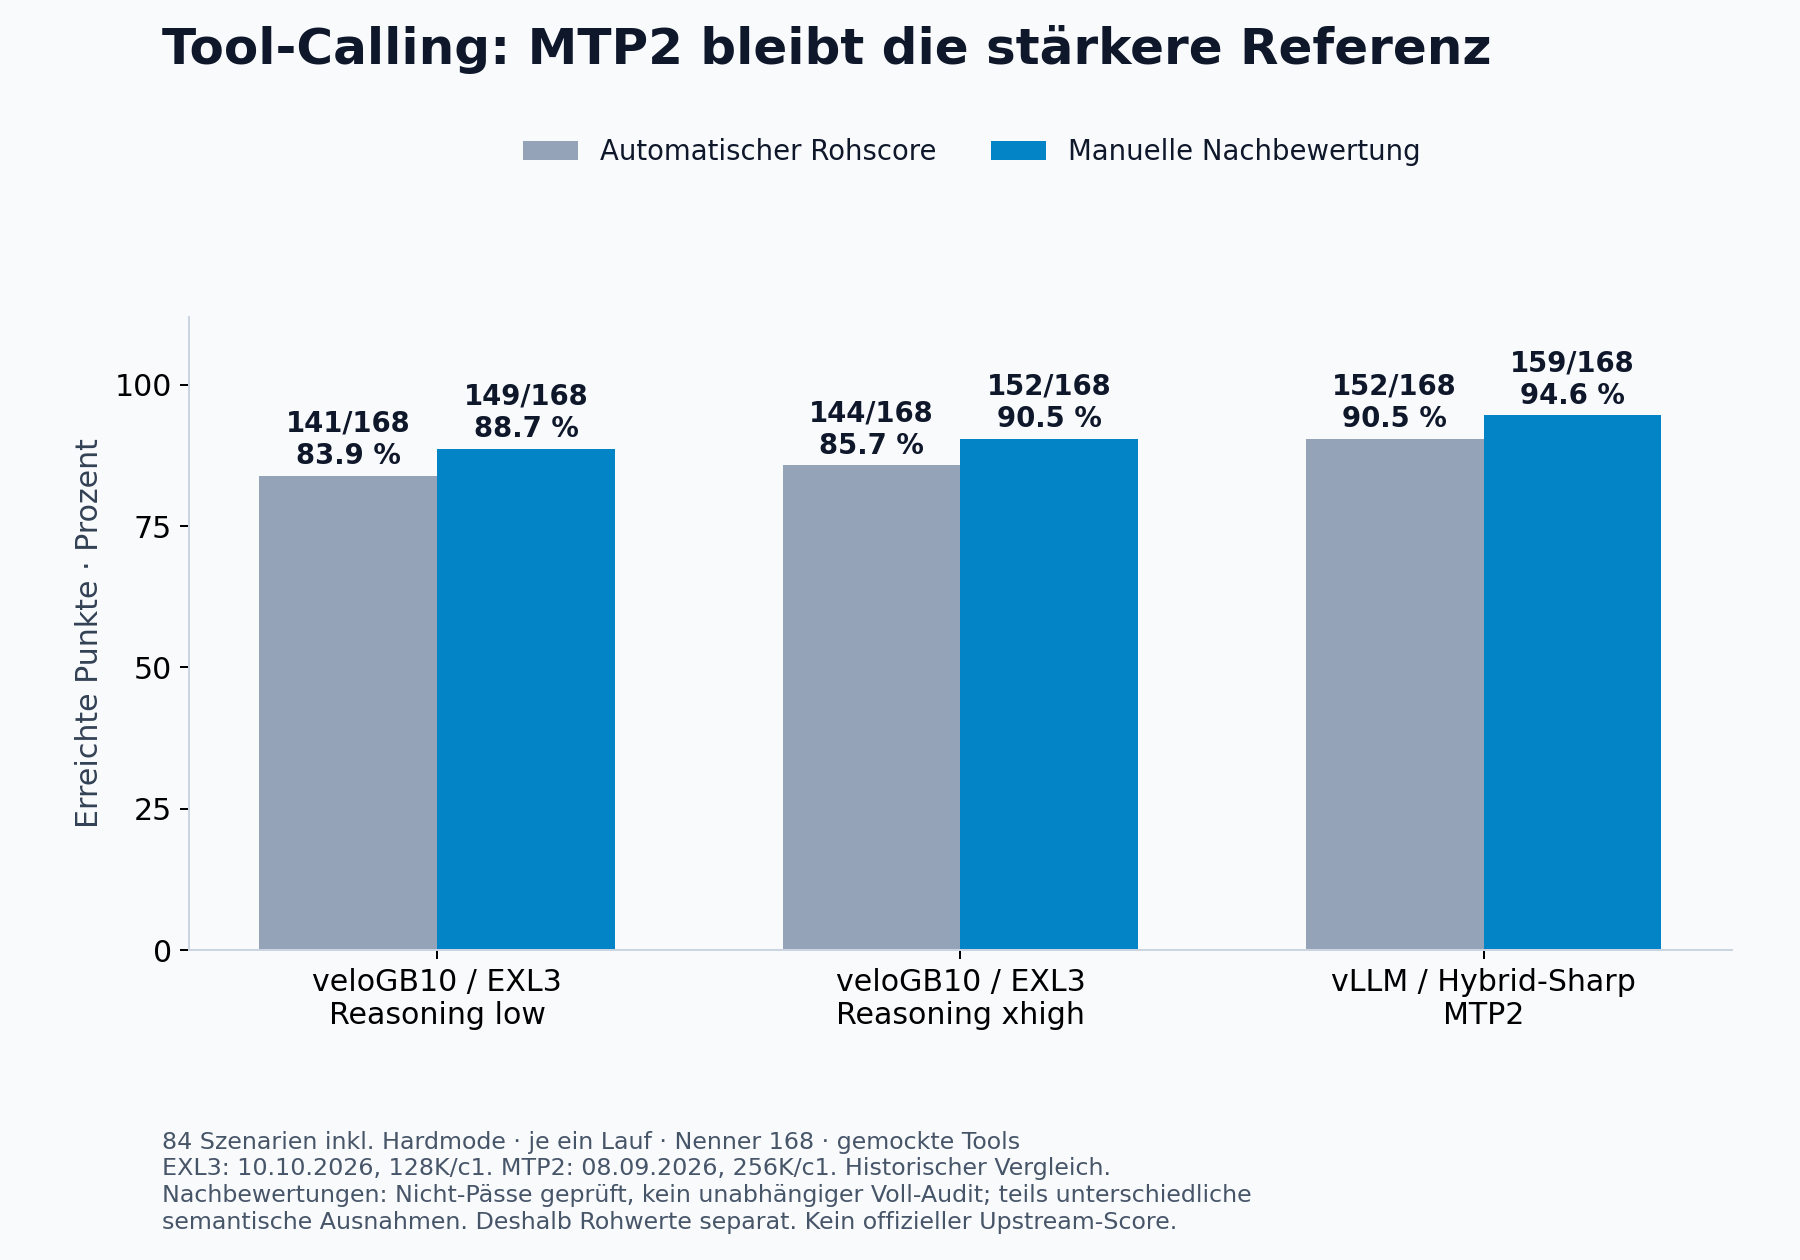
tool-eval-bench: 84 Szenarien, je ein Lauf. Rohwerte und Nachbewertungen getrennt; Prüfregeln teils unterschiedlich.
Die Suite tool-eval-bench prüft Werkzeug-Schemas, Empfänger und IDs, JSON-Vorgaben und mehrstufige Aktionen in der richtigen Reihenfolge. MTP2 liegt sowohl im Rohscore als auch nach manueller Prüfung der Nicht-Pässe vorn. Mehr Reasoning verbessert EXL3 etwas, schliesst die Lücke aber nicht. Die Grafik zeigt Rohwerte und Nachbewertungen getrennt. Die Reviews folgen ähnlichen Regeln, bilden aber kein einheitliches unabhängiges Audit. Für mich beschreiben die Zahlen eine praktische Abwägung zwischen Tempo und Tool-Disziplin. Dass die Quantisierung die Lücke verursacht, belegen sie nicht.
Die verbliebenen Fehler sind konkret. Empfänger landeten in einem nicht unterstützten cc-Feld, statt der geforderten Datei-ID hing ein Dateipfad am Versand, und JSON-only-Antworten kamen mit Markdown-Fences. Autorisierte Abläufe brach das Modell ab, um erneut nachzufragen.
veloGB10 selbst aufsetzen
Das folgende Kurzrezept nutzt die hier getestete Version v0.7.3 auf einer einzelnen DGX Spark beziehungsweise einem ASUS GX10 mit 128 GB Unified Memory. Benötigt werden ein funktionierender NVIDIA-Treiber, curl, Python 3 mit venv und rund 90 GB freier SSD-Platz für das EXL3-Pack, zusätzlich etwas Reserve. Einen bereits laufenden grossen Inferenzserver vorher beenden, damit dessen Speicher frei wird. Anders als beim vLLM-Rezept starten wir hier direkt die vorkompilierte Engine, ohne Docker und ohne eigenen Rust-/CUDA-Build.
1. Engine herunterladen
Das Release-Archiv v0.7.3 enthält die ARM64-Binary und die passenden PTX-Kernels. Beides muss zusammenbleiben; gestartet wird später aus dem entpackten Verzeichnis.
mkdir -p ~/veloGB10-setup
cd ~/veloGB10-setup
curl -fL -O https://github.com/sf-stav/veloGB10/releases/download/v0.7.3/velogb10-v0.7.3-gb10-sm121.tar.gz
tar -xzf velogb10-v0.7.3-gb10-sm121.tar.gz
2. EXL3-Modell laden
Wir verwenden das vollständige 3,05-bpw-Pack von doth4580, nicht die ursprünglichen BF16-Gewichte. Der Download umfasst auch Tokenizer, n-Gram-Datei und MTP-Zusatzgewichte. Ein separates Draft-Modell ist nicht nötig.
cd ~/veloGB10-setup
python3 -m venv .venv
.venv/bin/pip install --upgrade huggingface_hub
.venv/bin/hf download doth4580/Qwen3.8-Flash-Next-EXL3-3.05bpw \
  --revision 2f41a00997260a0fee9e26589617f5c5e212b36b \
  --local-dir ./Qwen3.8-Flash-Next-EXL3-3.05bpw
Die Revision fixiert den getesteten Modellstand.
3. Server starten
Wir verwenden das getestete Profil mit 256K Kontext, maximal vier gleichzeitigen Anfragen und der n-Gram-Tabelle auf SSD. MTP aktiviert die Engine automatisch.
cd ~/veloGB10-setup/velogb10
./gb10_inference --server \
  --model-dir "$HOME/veloGB10-setup/Qwen3.8-Flash-Next-EXL3-3.05bpw" \
  --host 127.0.0.1 --port 9000 \
  --max-seq-len 262144 --max-batch 4 --ple-ram ssd
Das Terminal bleibt geöffnet. Nach dem Laden meldet die Engine den lauschenden API-Port. Binary und Verzeichnis src/ptx/ dürfen nicht getrennt oder mit Dateien einer anderen Version gemischt werden.
4. API testen
In einem zweiten Terminal zunächst die Modellkennung abfragen:
curl -fsS http://127.0.0.1:9000/v1/models
Der getestete Stand meldete Qwen/Qwen3.8-Flash-Next. Damit folgt eine kurze Anfrage:
curl -fsS http://127.0.0.1:9000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"Qwen/Qwen3.8-Flash-Next","messages":[{"role":"user","content":"Erkläre in zwei Sätzen, was lokale Inferenz ist."}],"temperature":0,"max_tokens":256,"chat_template_kwargs":{"enable_thinking":false}}'
Als Basis-URL für einen OpenAI-kompatiblen Client dient http://127.0.0.1:9000/v1. Mit dieser Bindung ist die API nur auf dem Gerät erreichbar. Für einen Client auf einem anderen Rechner braucht es eine passende private Netzwerkadresse statt 127.0.0.1; nicht ungeschützt ins Internet stellen.
Mein Fazit
Ich teste Qwen3.8-Flash-Next auf veloGB10 weiter als produktiven Daily Driver. Für meine Nutzung ist der Geschwindigkeitsgewinn die moderaten Abstriche im Hardmode wert. Gezielte Systemprompts fangen die typischen Fehler in meiner Erfahrung weitgehend ab; eine Garantie oder ein Benchmark-Beleg ist das nicht. Wo Aktionen echte Folgen haben, gehört eine Schema-Prüfung für Empfängerfelder, IDs und JSON trotzdem dazu, genau wie eine menschliche Begutachtung und Freigabe.
veloGB10 behalte ich jedenfall im Blick und für den Moment im Betrieb. Seit dem Forum-Thread zu v0.7.0 ist die Engine bei v0.7.3 angekommen, und neue Versionen werde ich auf meinem GX10 wieder gegen diese Werte laufen lassen.
- →veloGB10 v0.7.3 von Stav Katsoulis (GitHub) · Release-Thread v0.7.0 (NVIDIA Developer Forum)
- →Qwen: Qwen3.8-Flash-Next, offizielle Modellkarte
- →doth4580: EXL3-Pack 3,05 bpw · turboderp: EXL3-Quantisierung (Hugging Face)
- →vcruz305: Qwen3.8-Flash-Next EXL3 DGX Spark Recipe (GitHub)
- →vLLM: Inferenz- und Serving-Engine (GitHub)
- →llama.cpp: LLM-Inferenz in C/C++ (GitHub)
- →llama-benchy, gepinnter Commit · tool-eval-bench 573a3ec (GitHub)