1 Beiträge
#LLM / Sprachmodelle
Alle Beiträge
Open-Source-KI
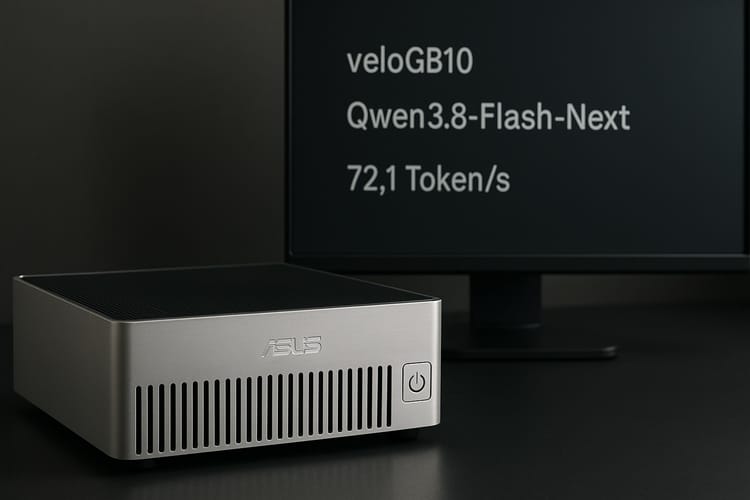
veloGB10 auf DGX Spark: Qwen3.8-Flash-Next im Praxistest
Ich habe Qwen3.8-Flash-Next als EXL3-Pack auf der GB10-Engine veloGB10 getestet. Der kurze Decode lag mit 72,1 tok/s rund doppelt so hoch wie in meinem früheren vLLM-Profil, im Tool-Calling-Hardmode gab es dafür leichte Abstriche.
1 / 1