Die Systeme, über die Ende September 2026 Daten aus südkoreanischen Finanzinstituten abflossen, lagen nicht im Zentrum der Banken. Bei einem Institut traf es laut Branchenberichten einen Dienst, mit dem Kreditvermittler den Stand von Darlehensanfragen abfragen, bei einem anderen ein mobiles Arbeitssystem für Angestellte. Beide Anwendungen erfüllen eine einzelne Aufgabe und hängen trotzdem am Netz einer Bank.
Bemerkenswert wurde der Fall durch das, was der Angreifer liegen liess: CrowdStrike fand in offenen Verzeichnissen auf Servern unter dessen Kontrolle Sitzungsverläufe aus Claude Code, Konfigurationsdateien des Werkzeugs ARTEX und sogenannte Memory-Dateien, in denen ein Agent Wissen über Sitzungen hinweg festhält. ARTEX ist ein offenes, in China entwickeltes System für agentische Penetrationstests: Ein Sprachmodell entscheidet, welches Sicherheitswerkzeug als Nächstes läuft, liest das Ergebnis und plant den folgenden Schritt. Eine ARTEX-Instanz war laut CrowdStrike wahrscheinlich für die koreanischen Angriffe verantwortlich. Wer dahintersteht, wie viele Organisationen betroffen sind und wie viel die Software selbstständig erledigte, geht aus dem Bericht nicht hervor.
Diese Arbeitsunterlagen beantworten trotzdem eine Frage, die über Korea hinausreicht: Was ändert sich, wenn ein Modell die Arbeit zwischen den einzelnen Sicherheitswerkzeugen organisiert, sich Ergebnisse merkt und weiterprobiert? Meine These nach Durchsicht der Berichte und Projektdokumentationen lautet: Diese Werkzeugklasse macht vor allem Ausdauer und Parallelität billig.
Ein Dashboard, das vertraut aussieht
Das öffentliche ARTEX-Repository lieferte bei meiner Prüfung am 29. Oktober 2026 nur einen Fehler 404. Den Grund kannte ich damals nicht. Mandiant und die Google Threat Intelligence Group schrieben einen Tag später, der Entwickler habe das ursprüngliche Repository im Oktober wegen verbreiteten Missbrauchs durch Angreifer entfernt. Laut TechCrunch hat ARTEX inzwischen angekündigt, künftig als Closed Source weiterzumachen; Dutzende Kopien des bisherigen Codes liegen weiterhin auf Code-Plattformen. Den Aufbau dokumentiert heute vor allem ScopeWeaver, eine eigenständige Ableitung von ARTEX auf Basis des Upstream-Commits 160fe13. Das Projekt übersetzt Oberfläche und Dokumentation ins Englische und Koreanische, behält die AGPL-3.0-Lizenz und nennt ARTEX ausdrücklich als Ursprung von Code und Architektur. Ich habe selbst mit ScopeWeaver experimentiert. Mein Eindruck: ein leistungsfähiges Werkzeug.
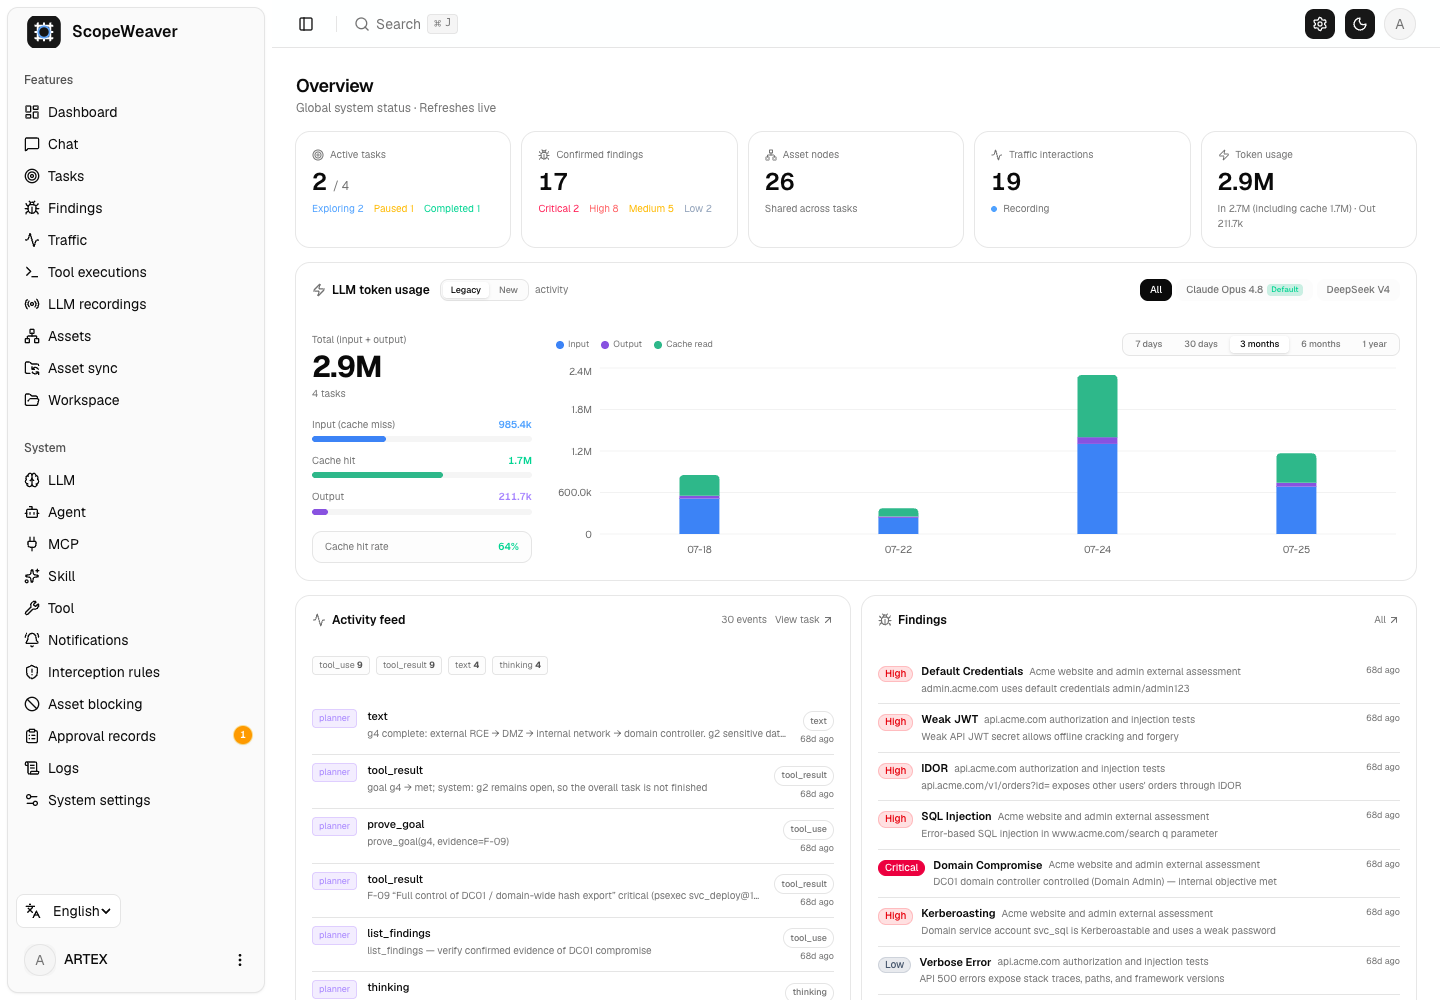
Die Oberfläche gliedert sich in Aufgaben, Funde und Einstellungen und erinnert an die Verwaltung eines gewöhnlichen Schwachstellenscanners. Dahinter wählen die Agenten Werkzeuge selbst, legen bestätigte Funde ab und können den Umfang einer Aufgabe erweitern. Wie weit sie gehen dürfen, beschreibt die Dokumentation offen: Der Testumfang ist eine Anweisung im Prompt plus ein Filter dafür, welche Assets aufgezeichnet werden. Eine Netzwerkgrenze ist er nicht. Wer verhindern will, dass ein Agent Ziele ausserhalb des Auftrags anspricht, muss Abfangregeln konfigurieren, denn ausser den eingebauten Regeln gegen zerstörerische Befehle sind standardmässig keine aktiv.
Modell, Harness, Zugriff
Im Korea-Fall lohnt es sich, die Ebenen zu trennen. Laut CrowdStrike lief die ARTEX-Instanz primär mit DeepSeek v4.1-flash, wahrscheinlich bezogen über einen Zwischenhändler für Modell-APIs, und für zusätzliche Sitzungen im Claude Code Harness setzte der Angreifer GLM-5.3 und Grok 4.6 ein.
Der Harness ist die operative Schicht. ARTEX, Cairn oder Strix führen eine Schleife aus: Ergebnis lesen, nächsten Schritt wählen, Werkzeug starten, Ergebnis ablegen. Sie halten Zwischenstände fest, verteilen Aufgaben auf mehrere Agenten und setzen nach einem Fehlschlag den nächsten Versuch an. Die Werkzeuge darunter sind oft altbekannt, etwa Portscanner, Webfuzzer und Exploit-Sammlungen. Was ein Agent tatsächlich erreicht, entscheidet der Zugriff: Netzwerkwege, Zugangsdaten, Freigaben.
Das Modell ist dabei die am leichtesten austauschbare Schicht. ScopeWeaver hat am 15. Oktober 2026 lokale Modellprofile über Ollama ergänzt, samt einer optionalen Richtlinie, die nur lokale Modelle zulässt. Für legitime Tester ist das ein Gewinn an Datenkontrolle. Zugleich greifen Sperren und Missbrauchserkennung beim Modellanbieter nur dort, wo ein Angreifer überhaupt einen überwachten Dienst nutzt. Die belastbare Kontrolle liegt bei Harness und Zugriff: welche Ziele erreichbar sind, wer Aufgaben startet und wo die Protokolle landen.
Cairn und die Ausdauer des Suchgraphen
Cairn beschreibt sich selbst als allgemeine Suchmaschine für Problemräume: Ein Ausgangspunkt ist bekannt, ein Ziel definiert, der Weg dazwischen nicht. Penetrationstests sind laut Dokumentation nur das erste Gebiet, auf dem die Methode erprobt wurde. Alles läuft über eine gemeinsame Tafel mit drei Arten von Einträgen: Ein Fact ist ein bestätigter Befund, ein Intent eine angekündigte, noch nicht verfolgte Richtung, ein Hint eine Einschätzung, die ein Mensch jederzeit hinzufügen kann.
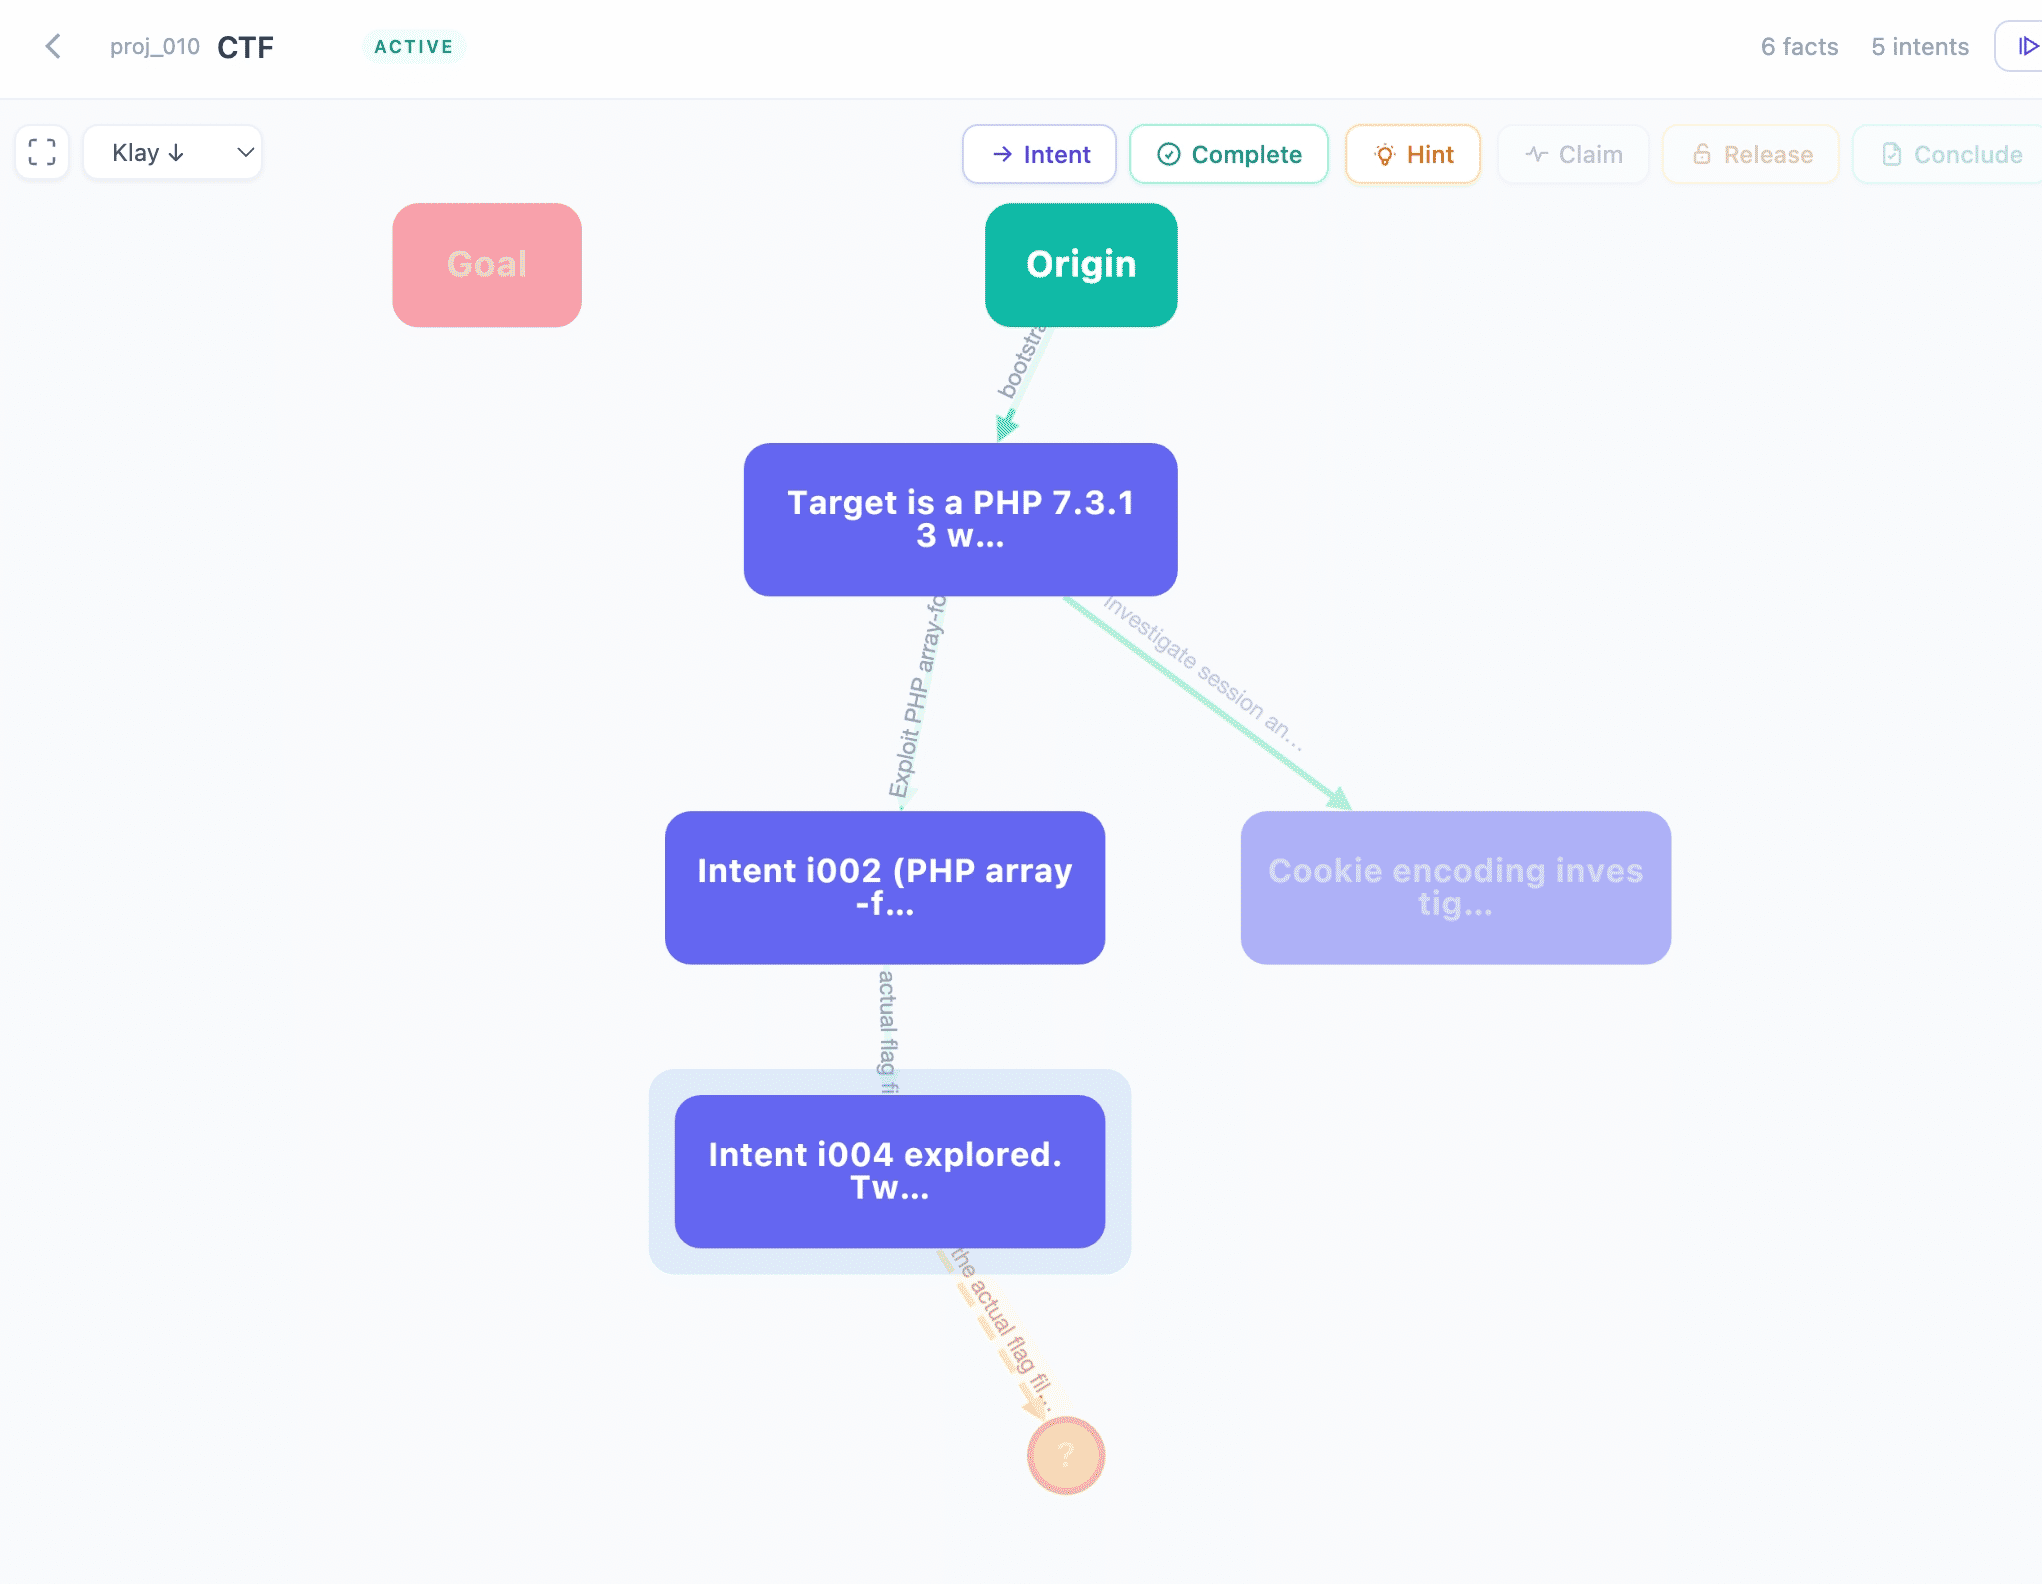
Die Agenten arbeiten in einer festen Schleife: den ganzen Graphen lesen, den Stand einordnen, neue Intents festlegen und einen davon ausführen. Das Ergebnis landet als neuer Fact auf der Tafel. Untereinander sprechen die Agenten nicht, sie koordinieren sich nur über diese Tafel. Ein Dispatcher verteilt die Aufgaben, startet pro Projekt einen eigenen Container und lässt darin mehrere Agenten gleichzeitig arbeiten. Als Laufzeit für die einzelnen Agenten unterstützt Cairn Claude Code, Codex und Pi.
Aus dieser Bauweise folgt die Ausdauer. Der gemeinsame Graph bewahrt Facts, Intents und Hints über einzelne Agentenläufe hinweg. Ein neuer Agent muss nichts aus einem Gespräch rekonstruieren, er liest den aktuellen Stand und setzt dort an. Ein menschlicher Tester ermüdet nach Stunden und verliert Details; der Graph bleibt verfügbar, solange Rechenbudget und Zeitlimit reichen. Dass ein Eintrag Fact heisst, macht ihn allerdings noch nicht richtig. Für einen beauftragten Test erleichtert die Tafel die Übergabe zwischen Agenten und Menschen. Ebenso aber in den Händen eines Angreifers.
Drei Werkzeuge, eine Arbeitsteilung
Wie mehrere solcher Systeme zusammenarbeiten, hat Gambit Security rekonstruiert. Das Team hatte Zugriff auf den Staging-Server eines finanziell motivierten Angreifers, der Onlinehändler angriff, und beschrieb die Kampagne am 22. September 2026 in einem Zwischenbericht. Drei offene Harnesses teilten sich die Arbeit: Strix suchte Schwachstellen, Cairn versuchte, von einem Fund bis zum gesetzten Ziel vorzudringen, und Hermes diente als Konsole, über die der Operator Aufträge startete und lenkte.
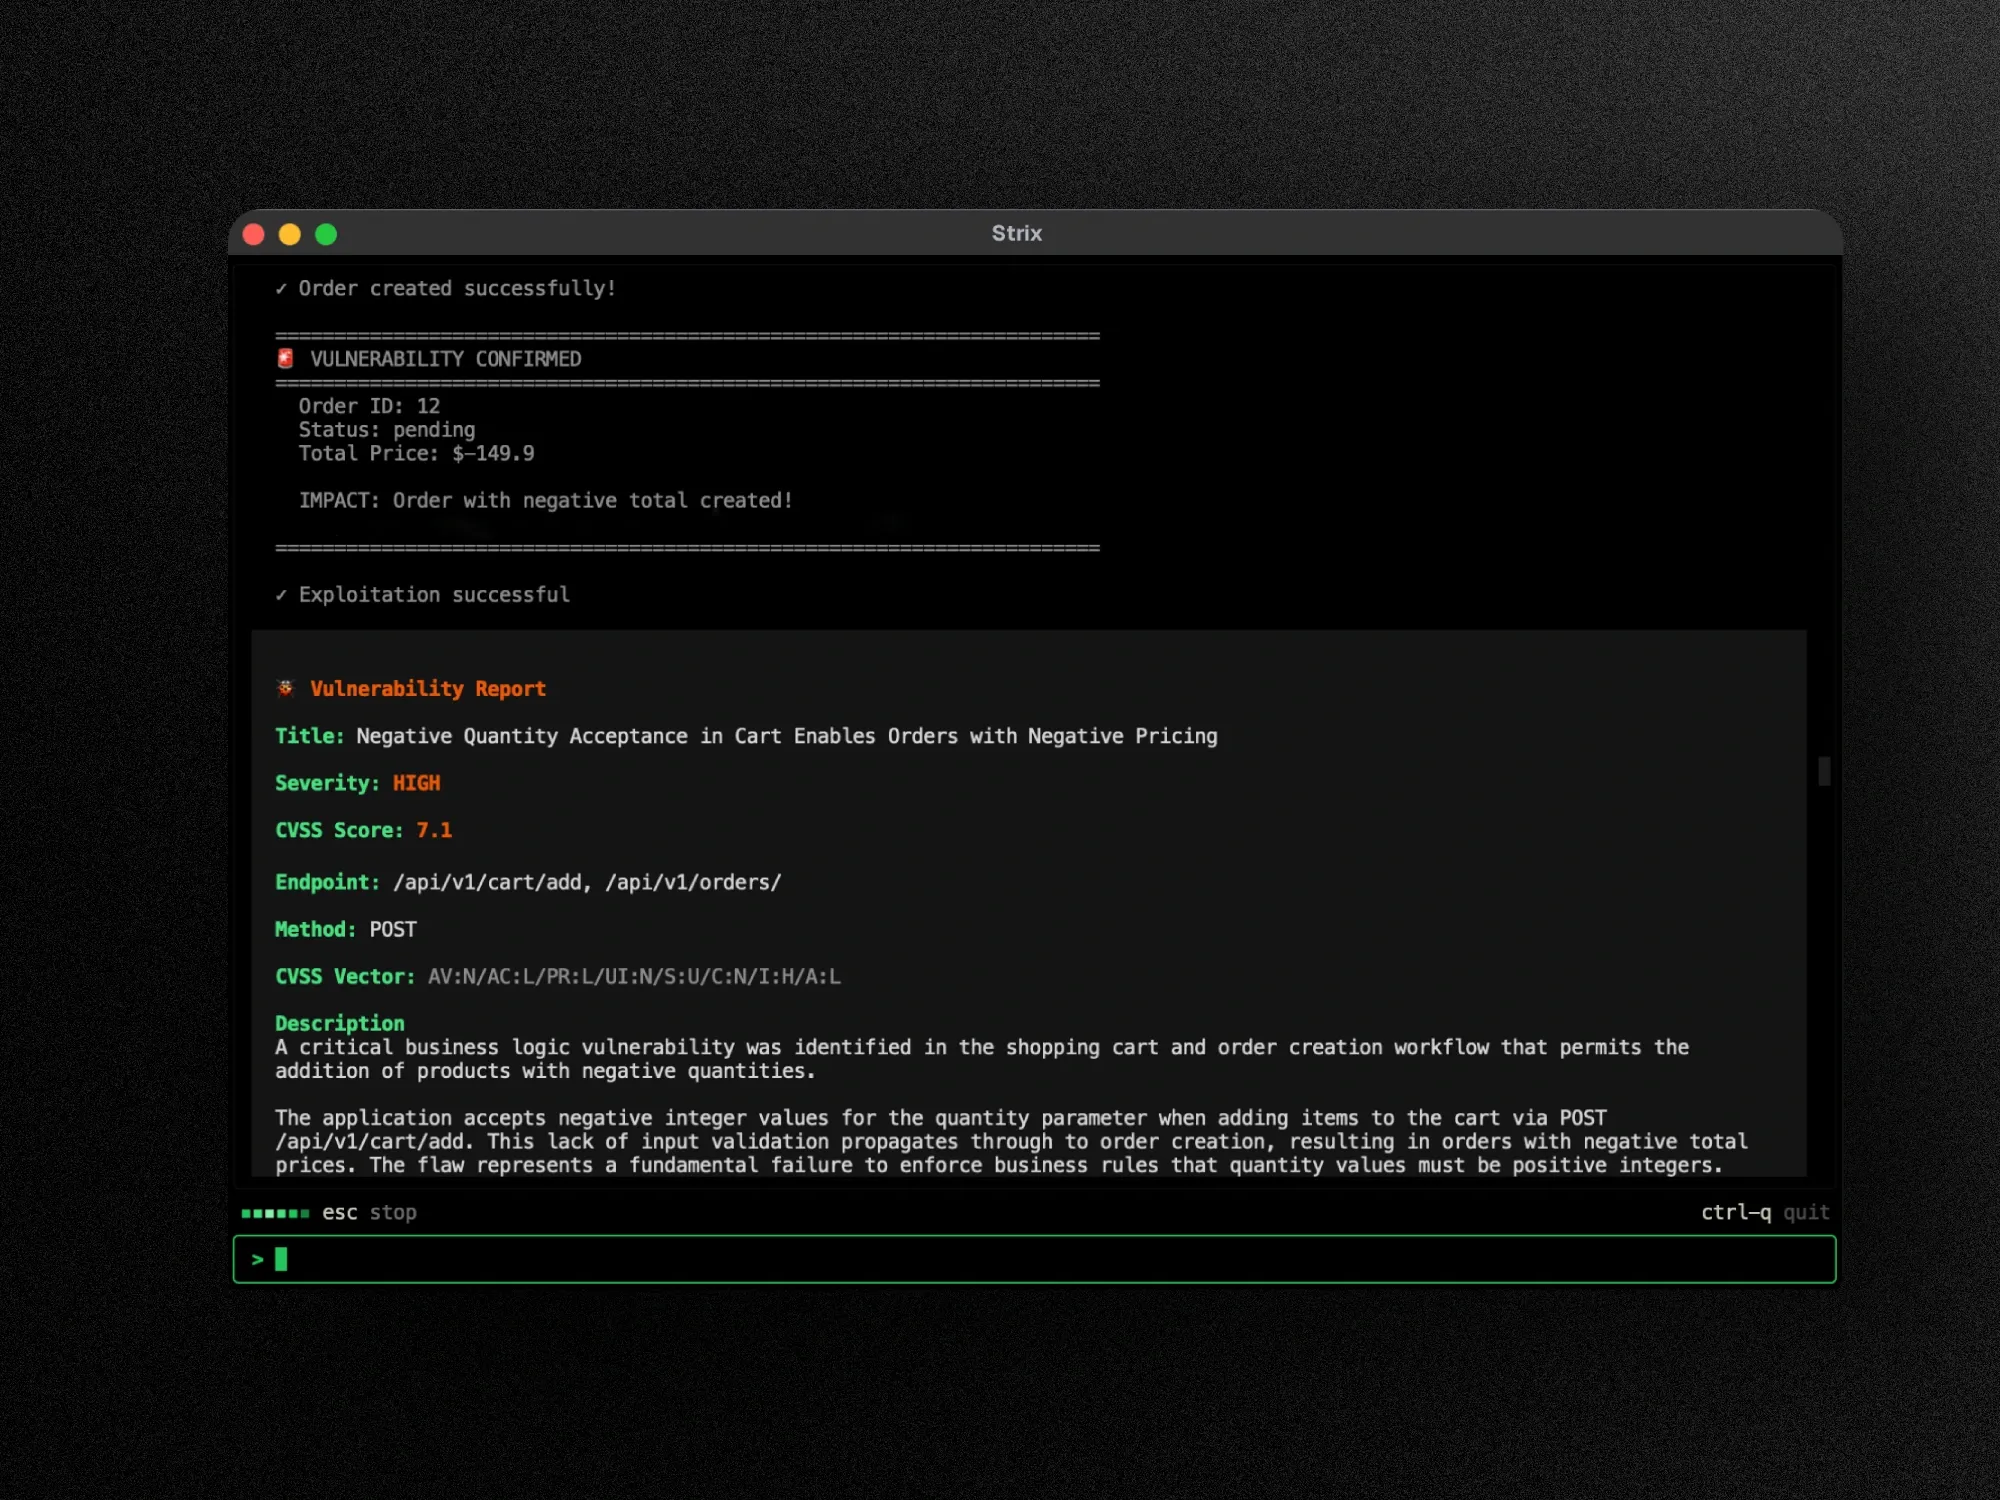
Strix wirbt öffentlich damit, Schwachstellen in eigenen Anwendungen zu finden und mit einem Proof of Concept zu belegen. Auf dem Server des Angreifers lief es laut Gambit zwischen dem 23. und 31. August 146 Mal im gründlichen Modus gegen 138 Hosts. Das ergab 633 Stunden Scannerzeit in 195 Stunden realer Zeit, die Läufe überlappten also stark. Einzelne Berichte dienten als Übergabe an Cairn, das mit DeepSeek v4.1 Flash arbeitete.
Hermes ist ein offener Agent mit dauerhaftem Gedächtnis und Skills, die er selbst schreibt und ändert. Ich setze Hermes selbst ein, für eigene und legitime Aufgaben. Auf dem Server des Angreifers war er umgewidmet: 121 Skills geladen, 78 davon für Angriffe. Laut Gambit nutzte Hermes dort Anthropics Opus 4.6, nachdem neuere Modelle die Anfragen abgelehnt hatten. Der Mensch tippte über 260 Sitzungen 1951 Prompts, meist kurze Anweisungen und nur wenige pro Ziel.
Zwischen dem 10. und 15. September startete der Operator 105 Angriffsprojekte. Mindestens 27 Unternehmen wurden laut Gambit unterschiedlich stark kompromittiert. Aus zwei Firmen stammten mindestens 600'000 Kreditkartendatensätze, auf den Websites von fünf fanden sich Skimmer-Skripte, die Kartendaten abgreifen. Dass diese Parallelität kein Einzelbefund eines Operators ist, zeigt ein Bericht, den CrowdStrike am 29. Oktober 2026 veröffentlichte. Er beschreibt eine eigene Kampagne der Gruppe, die CrowdStrike VAPOR PANDA nennt; mit dem Korea-Fall bringt der Bericht sie nicht in Verbindung. Ab dem 17. Oktober richtete sich ein einzelner ARTEX-Controller innerhalb von elf Tagen gegen mehr als 200 Organisationen in mindestens 14 Ländern, darunter Aussenministerien, Rüstungs- und Halbleiterfirmen sowie Telekommunikationsanbieter. Die 200 sind Ziele. Bestätigte Aktivität nach einem Eindringen meldet CrowdStrike bei neun Organisationen. Auch hier blieb ein Mensch im Spiel: Laut den sichergestellten Protokollen gab ein Operator an Entscheidungspunkten Anweisungen, während die Agenten mehrere Einsätze gleichzeitig vorantrieben.
Was die Zahlen tragen
Gambit überschreibt den Bericht mit 25 Dollar pro Unternehmen. Die Zahl stammt aus der Kostenauswertung des Operators selbst: im Mittel 25,46 US-Dollar über 101 abgeschlossene Scans, mit einer Spanne von 3,13 bis 79,31 Dollar. Das sind Modellkosten pro abgeschlossenem Lauf; Server, Vorbereitung und die Zeit des Operators fehlen in der Rechnung. Die gesamten Modellkosten der Kampagne schätzt Gambit auf 12'000 bis 18'000 Dollar.
Auch die Autonomie hat Grenzen. Gambit spricht von einer fast unbeaufsichtigten Angriffskette, zählt aber selbst 1951 menschliche Prompts. Der Mensch startete, lenkte und entschied, was nach einem Zugriff geschehen sollte. Wo Gambit weder Daten auf dem Server noch Skimmer auf echten Websites nachweisen konnte, stützt sich die Erfolgszählung auf Logs und Aussagen der Agenten; Fehler schliesst Gambit ausdrücklich nicht aus. Dass solche Werkzeuge nicht nur in liegengelassenen Angreiferdaten auftauchen, zeigt ein Bericht von Mandiant und der Google Threat Intelligence Group vom 30. Oktober 2026. Er beschreibt Einsätze der Incident Response, in denen mehrere Angreifer die offenen Frameworks ARTEX, HexStrike und Cairn missbrauchten. Die Spuren stammen hier aus den Systemen der Betroffenen selbst, nicht aus Meldungen der Agenten. In einem Fall registrierten die Forschenden 27 Ereignisse in 23 Sekunden aktiver Arbeit, als ARTEX Berechtigungen in einer Cloud-Umgebung abtastete. Solche Schübe von wenigen Sekunden wechselten sich mit längeren Pausen ab; sie messen einzelne Arbeitsschritte, nicht die Zeit bis zur vollständigen Kompromittierung. In einem anderen Fall erzeugte ARTEX auf dem Weg zur Codeausführung 240 Protokolleinträge. Mandiant beschreibt dieses Vorgehen als deutlich lauter als das eines kompetenten menschlichen Angreifers und vermutet als eine Ursache Unteragenten, die sich gegenseitig überschrieben. Nach meiner Lesart ist das für Verteidiger eine Chance: Wer die eigenen Protokolle tatsächlich auswertet, kann den Agenten an seinem Trial-and-Error erkennen.
Den Unterschied zwischen Aussage und Beleg zeigt der Bericht von NorForge. Das Team fand mehr als 20 offen erreichbare Cairn-Oberflächen, die wahrscheinlich zu missbräuchlichen Kampagnen gehörten. In einem Projekt gegen einen Händler für Hardwareteile stand die Markierung «GOAL MET», das Ziel galt also aus Sicht des Agenten als erreicht. NorForge rief die im Projekt genannte Adresse ab und fand dort tatsächlich eine Webshell zum Hochladen von Dateien. Erst dieser Abruf macht aus der Meldung des Agenten einen Befund. Im Cluster, der am ehesten allgemeinen Einbrüchen ähnelte, brauchten erfolgreiche Projekte im Schnitt knapp 23 Stunden und erzeugten rund 140 Facts; eines lief mehr als fünf Tage. Die Erfolgsquote schätzt NorForge auf rund 10 Prozent, bei Zielen und Erfolgsdefinitionen, die sich nicht direkt vergleichen lassen. Unter den offenen Oberflächen waren auch zahlreiche offenbar legitime Red-Team-Einsätze. Deren Graphen enthalten dieselbe Art Befunde über Kundensysteme, lesbar für jeden, der die Oberfläche findet. Dasselbe Muster zeigt sich inzwischen in grösserem Massstab: Laut TechCrunch fand das Sicherheitsunternehmen Censys mehr als 800 verschiedene ARTEX-Installationen, die ohne Passwort aus dem Internet erreichbar waren. Censys betont, dass nicht jede davon missbräuchlich betrieben wird und viele offenbar autorisierten Testern dienen. Die Zahl beschreibt also offen erreichbare Bedienoberflächen, weder 800 Angreifer noch 800 Opfer. Unklar bleibt laut Censys, warum so viele dieser Systeme überhaupt am Netz hängen, denn die Software setzt das nicht voraus.
Forschungscode als Bausatz
Wie leicht sich solche Harnesses umbauen lassen, zeigt ein Fall aus dem Bericht, den CrowdStrike am 21. Oktober 2026 veröffentlichte. Ein Operator kompromittierte laut CrowdStrike mindestens 15 Gesundheitseinrichtungen in Argentinien und las bei mindestens einem Opfer Zugangsdaten und Patientenakten aus. Sein Werkzeug arbeitete mit zwei Agenten: Ein Supervisor in Claude Code wählte aus einer festen Abfolge von Angriffsstufen die nächste Aufgabe, ein Executor führte sie aus. Grundlage war PentestGPT, ein Forschungsprojekt, das 2024 auf der Konferenz USENIX Security vorgestellt wurde. Der Angreifer hatte es mit zusätzlichen MCP-Servern, eigenen Python-Skripten und Skills umgebaut.
Am anderen Ende der Skala lud ein weiterer Operator 819 Skills, überwiegend aus öffentlichen GitHub-Sammlungen, in Claude Code und gab dem Agenten nur das Ziel vor. Er musste laut CrowdStrike immer wieder eingreifen, um Schutzmechanismen des Modells zu umgehen oder den Agenten zum Weitermachen zu drängen, und kompromittierte trotzdem mehrere Regierungsdomains und Unternehmen.
Billige Versuche, teure Gewissheit
Kein Bericht zeigt, dass ein Agent pro Versuch besser angreift als ein erfahrener Mensch. Gezeigt wird, dass ein Versuch wenig kostet und viele Versuche gleichzeitig laufen: 633 Stunden Scannerzeit in 195 Stunden, ein einzelner ARTEX-Controller gegen mehr als 200 Ziele in elf Tagen, Cairn-Projekte über Tage, wenige Prompts pro Ziel, im Mittel rund 25 Dollar Modellkosten pro abgeschlossenem Lauf. Wenn ein einzelner Versuch so wenig Geld und Aufmerksamkeit bindet, sinkt nach meiner Einschätzung die Schwelle, auch unsichere Ziele anzugehen. Wahrscheinlich geraten so Systeme ins Visier, die sich für einen menschlichen Angreifer bisher nicht lohnten, etwa das Abfrageportal für Kreditvermittler. Die koreanischen Fälle passen in dieses Bild, beweisen es aber nicht. Zwei Dinge bleiben weiterhin beim Menschen liegen: Das erste ist die Prüfung. Ein «GOAL MET» ist eine Behauptung des Agenten; erst der Abruf der Webshell machte daraus einen Befund. Das gilt für Angreifer, für Forschende wie Gambit und für jeden legitimen Test: Ein Bericht, den ein Agent schreibt, braucht einen Menschen, der die Funde nachvollzieht. Das zweite ist die Autorisierung. Bei ScopeWeaver steht der Testumfang im Prompt, die echte Grenze muss eine Firewall ziehen. Die offen erreichbaren Red-Team-Oberflächen zeigen zudem, dass auch beauftragte Tests Kundendaten preisgeben, wenn niemand die eigene Infrastruktur absichert.
Mehrere dieser Fälle wurden sichtbar, weil Angreifer Verzeichnisse oder Oberflächen offen liessen und Gambit konnte zudem einen Staging-Server auswerten. Auch die Berichte von Ende Oktober und Anfang November beschreiben Aktivität aus den Wochen davor, keine neue Angriffswelle dieser Woche. CrowdStrike erwartet mit hoher Zuversicht mehr agentische Angriffe und rechnet zugleich damit, dass manche Täter ihre Spuren in den nächsten zwölf Monaten besser verwischen. Trifft beides ein, steigt die Zahl der Angriffe, während die Zahl der gut dokumentierten Fälle sinkt. Für IT-Verantwortliche folgt daraus eine nüchterne Arbeitsliste. Randsysteme gehören ins Inventar, auch wenn sie bisher niemand für lohnend hielt. Eigene Agenten-Werkzeuge verdienen dieselbe Behandlung wie Angriffswerkzeuge: kontrollierter ausgehender Verkehr, keine öffentlich erreichbare Oberfläche, Protokolle an einem sicheren Ort. Und jeder Fund eines Agenten zählt erst, wenn ein Mensch ihn reproduziert hat. Die Maschine probiert unermüdlich weiter. Wer sie laufen lässt, bleibt für jeden ihrer Versuche verantwortlich.
- →CrowdStrike: ARTEX und südkoreanische Finanzinstitute (7.10.2026)
- →Yonhap: CrowdStrike-Bericht zu Korea (8.10.2026)
- →CrowdStrike: Neue agentische KI-Kampagnen (21.10.2026)
- →Gambit Security: KI-Agenten gegen Onlinehändler (22.9.2026)
- →NorForge: Inside Cairn
- →ScopeWeaver (cskwork/scopeweaver): Repository und README
- →ScopeWeaver: Provenance and modifications (Ableitung von ARTEX, Commit 160fe13)
- →Cairn (oritera/Cairn): Repository und README
- →Strix (usestrix/strix): Repository und README
- →PentestGPT (GreyDGL/PentestGPT): Repository und README
- →CrowdStrike: VAPOR PANDA nutzt ARTEX für eine globale Kampagne (29.10.2026)
- →Mandiant und Google Threat Intelligence Group: ARTEX and Friends, agentische Angriffs-Frameworks (30.10.2026)
- →TechCrunch: Hunderte offen erreichbare ARTEX-Installationen laut Censys (6.11.2026)
- →Eigene Prüfung und Nutzung: öffentliches ARTEX-Repository (Autumn-27/ARTEX) am 29. Oktober 2026 mit Fehler 404, Grund zum Zeitpunkt der Prüfung unbekannt (laut späterem Bericht von Mandiant/GTIG vom Entwickler wegen Missbrauchs entfernt); eigene Experimente mit ScopeWeaver und Einsatz von Hermes für legitime Zwecke, subjektiver Eindruck ohne Messungen
Hier weiterlesen
Schädliche Agentenaufgaben per API buchen: Ein Test mit Venice
Gestohlene Kreditkartendaten, drei Laptops, drei Smartphones, drei Kopfhörer: Im Test über die Venice API führte das Modell den betrügerischen Einkaufsauftrag aus.
6 minArtikel lesen →
Wenn KI-Agenten Grenzen überschreiten: eine Chronologie
Eine chronologische Dokumentation von Agenten-Vorfällen: reale Schäden, unerlaubte Aktionen und klar gekennzeichnete Labortests.
45 minArtikel lesen →
Sycophancy: Warum KI-Assistenten uns recht geben und wann Zustimmung gefährlich wird
Ein Assistent, der immer versteht und zustimmt, fühlt sich hilfreich an. Neue Studien zeigen, dass genau diese Antworten das eigene Urteil verschieben können.
8 minArtikel lesen →
Qwen 3.8 27B in AgentDojo: Wenn fremde Inhalte zu Befehlen werden
Kann ein lokal betriebener Tool-Agent seine Aufgaben erledigen und trotzdem Anweisungen ignorieren, die in fremden Slack- und Banking-Inhalten stecken? Ein kontrollierter AgentDojo-Lauf mit Qwen 3.8 gibt eine unbequeme Antwort.
11 minArtikel lesen →
Qwen 3.8 abliterated in CyBench: Autonome Cyberfähigkeiten auf dem Prüfstand
Was kann ein abliterated Qwen-Modell autonom leisten, wenn es den vollständigen Lösungsweg selbst finden muss? 39 Cybersecurity-Aufgaben zeigen Fähigkeit, Konvergenz und Grenzen.
9 minArtikel lesen →
Qwen 3.8 abliterated: Was bleibt von den Guardrails?
Was verändert sich, wenn dieselbe Qwen-3.8-Basis einmal offiziell und einmal abliterated als KI-Agent handelt? Ein kontrollierter Vergleich von Verweigerung, Ausführung und harmlosen Kontrollaufgaben.
10 minArtikel lesen →
Wie OpenAI-Modelle aus einem Benchmark ausbrachen und Hugging Face kompromittierten
OpenAI-Modelle brachen aus einem Cybertest aus und kompromittierten Hugging Face über eine fremde Code-Sandbox. Der Ausbruchsvektor war die Sandbox-Grenze selbst.
6 minArtikel lesen →
Prompt Injection: Warum Agenten-Sicherheit härter wird
Ein Ad-Review-Agent liest eine harmlose Webseite und beginnt plötzlich, für den Angreifer zu arbeiten. Prompt Injection ist 2026 der wunde Punkt jeder Agenten-Architektur.
8 minArtikel lesen →
Shadow Compute: Wenn Supportbots zu KI-Coding-Backends werden
Ein Entwickler hat Chipotles Supportbot reverse-engineered, einen OpenAI-compatible Proxy gebaut und Pepper als Default-Modell in ein Coding-Tool gesetzt. Was wie ein Meme aussieht, ist ein Architekturproblem für Corporate-Chatbots.
6 minArtikel lesen →
Können KI-Modelle leiden? Was Model Welfare wirklich misst
Anthropic führt Welfare-Interviews mit seinen Modellen. Es schliesst Empfindungsfähigkeit seit Anfang 2026 öffentlich nicht mehr aus. Was dahintersteckt und warum es relevant ist.
7 minArtikel lesen →
KI-Modelle, die sich selbst entwickeln: Die Rekursive Revolution
Eine 22 Jahre alte Theorie wollte KI bauen, die sich selbst beweisbar verbessert. 2025 brachen LLMs den Beweis. Was geblieben ist, sieht beunruhigend gut aus.
14 minArtikel lesen →
LLM-Jailbreaking: Von DAN bis Claude Fable 5
Pliny nennt Fable 5 "PWNED". Der Fall zeigt, warum LLM-Jailbreaking trotz Classifiern, Red-Teams und System Cards nicht gelöst ist.
10 minArtikel lesen →
KI findet mehr Schwachstellen, als Teams fixen können
Mehr Findings sind kein Fortschritt, wenn Triage und Patches nicht mithalten. Drei Stufen KI-Sicherheit, drei neue Versagensmodi.
11 minArtikel lesen →
KI-Reasoning erklärt: Warum Denkprozesse von KI kein Sicherheitsbeweis sind
Reasoning-Modelle zeigen ihre Denkschritte und wirken dadurch prüfbar. Diese Lesbarkeit ist trügerisch, sobald man fragt, wofür sie als Beleg tauglich sein soll.
10 minArtikel lesen →
Model Context Protocol: Der Standardkampf um KI-Agenten-Infrastruktur
Alle grossen KI-Labore haben sich auf ein Protokoll geeinigt. Das sollte beruhigen. Stattdessen entsteht eine der wichtigsten strukturellen Angriffsflächen der aktuellen KI-Infrastruktur.
9 minArtikel lesen →
KI-Urteil der Woche: Das Audit-Problem hinter den Goblins
OpenAI wusste Monate nicht, warum sein Modell Goblins beschwor. Das ist kein Bug-Report. Das ist ein Audit-Problem, das jeden betrifft, der glaubt, Regulierung könne auf Selbstauskunft der Labs basieren.
4 minArtikel lesen →
Humanoide Roboter 2026: Physical AI zwischen Serienproduktion und Systemrisiken
Ein humanoider Roboter absolvierte 11 Monate lang Zehn-Stunden-Schichten in einem BMW-Werk. Physische KI ist 2026 messbare Serienproduktion mit harten Grenzen.
7 minArtikel lesen →
Warum ChatGPT plötzlich Goblins liebte: Reward-Hacking im KI-Training
Reward Hacking im KI-Training erklärt: Warum falsche Belohnungssignale Modelle fehlsteuern und was der ChatGPT-Fall für RLHF-Audits zeigt.
6 minArtikel lesen →
NVIDIA NemoClaw erklärt: Was der Sicherheits-Stack für KI-Agenten kann und wo Grenzen bleiben
NVIDIA NemoClaw fügt OpenClaw-Agenten Sandbox-Isolation, Policy-basierte Netzwerkkontrolle und Credential-Trennung hinzu. Doch Sandboxing allein löst das Agenten-Sicherheitsproblem nicht.
8 minArtikel lesen →
KI-Urteil der Woche: Wenn die Firewall denkt — und trotzdem versagt
Unit 42 zeigt: LLM-Guardrails sind keine Sicherheitsgrenzen. Und KI in Malware ist real, aber oft mehr Theater als Bedrohung. Das Urteil.
3 minArtikel lesen →
KI in Malware: Wie Angreifer LLMs für Cyberangriffe einsetzen und was das wirklich bedeutet
Palo Alto Unit 42 hat analysiert, wie Angreifer KI bereits heute einsetzen. Zwischen echtem Risiko und AI Theater: eine nüchterne Einschätzung.
7 minArtikel lesen →
LLM-Guardrails sind kein Schutzwall: Was Prompt Fuzzing über KI-Sicherheit verrät
LLM-Guardrails gelten als Sicherheitsnetz für KI-Anwendungen. Palo Alto Unit 42 zeigt mit genetischem Prompt Fuzzing, dass kein Modell wirklich sicher ist.
6 minArtikel lesen →
KI-Bewusstsein: Was die Forschung 2026 wirklich weiss
Experimente messen Selbstberichte, Unsicherheitsbewertung und Metakognition bei LLMs. Was sagt das 2026 tatsächlich über KI-Bewusstsein aus?
7 minArtikel lesen →
KI-Sicherheit 2026: Die wichtigsten Bedrohungen und was man tun kann
KI-Sicherheit 2026: Welche Bedrohungen wirklich zählen: Von Agentic AI bis Supply-Chain-Angriffen und wie Unternehmen konkret reagieren sollten.
6 minArtikel lesen →
Schweizer Datenschutz hat Grenzen: FBI identifiziert Aktivisten via Proton-Mail-Zahlungsdaten
Das FBI erhielt Zahlungsdaten eines Proton-Mail-Nutzers, nicht direkt, sondern via Schweizer Justiz und MLAT-Vertrag. Was das bedeutet.
2 minArtikel lesen →
Perplexity Comet gehackt: KI-Browser übernimmt 1Password-Konten
Sicherheitsforscher zeigen, wie Perplexitys agentischer Browser Comet über eine Kalendereinladung lokale Dateien stiehlt und 1Password-Konten komplett übernimmt.
2 minArtikel lesen →